Der Workstation-Blog
Nvidia
Beiträge mit dem Tag Nvidia.
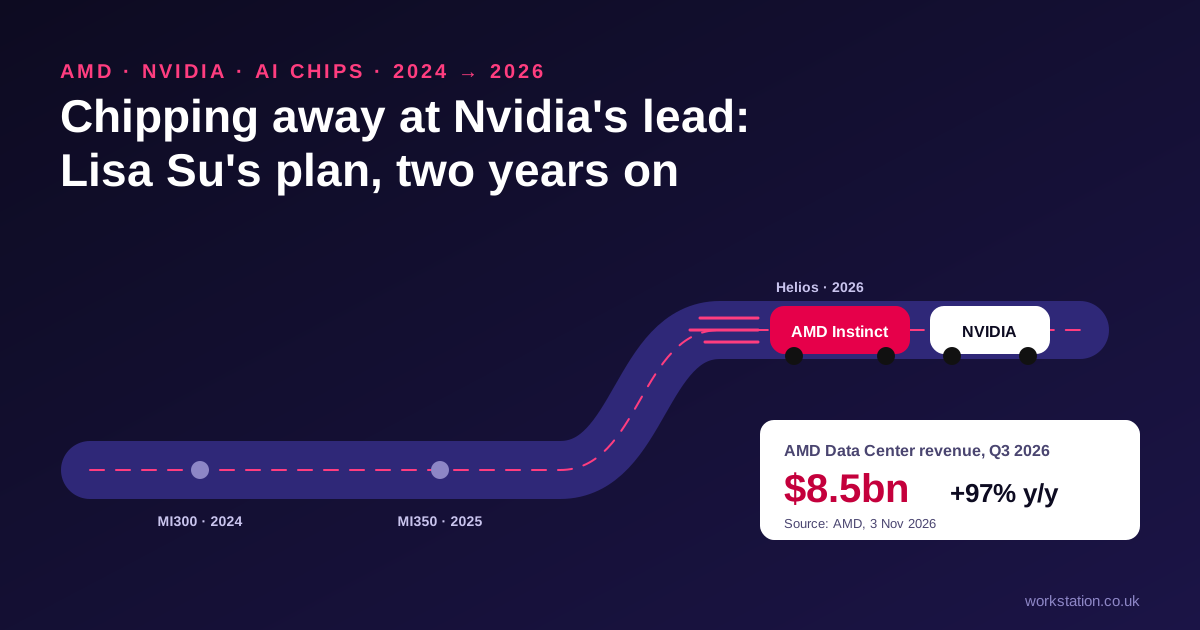
Chipping Away at Nvidia's Lead: Lisa Su's AMD Plan, Two Years On
In December 2024 Bloomberg's The Circuit asked AMD CEO Lisa Su how she would chip away at Nvidia's lead in AI. We check the plan against AMD's 2026 results and Helios launch, and explain what a credible second AI platform means for UK buyers. Includes a link to the interview.
 WorkstationLesen
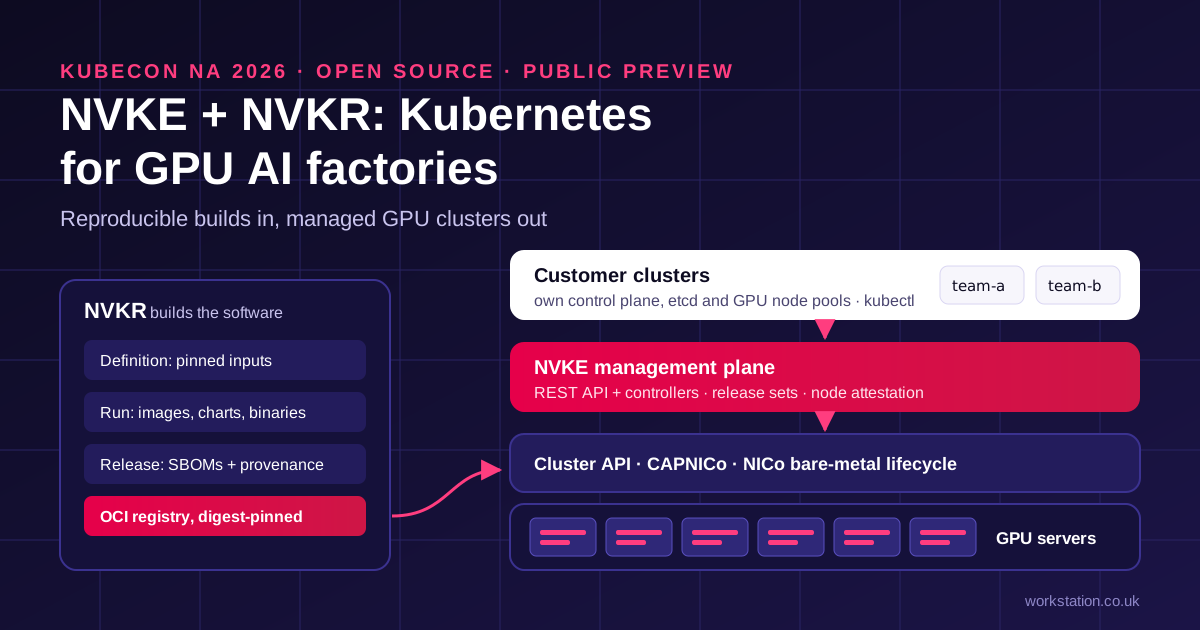
NVIDIA NVKE und NVKR: Warum GPU-Kubernetes zum Betriebssystem der KI-Fabrik wird
NVIDIA hat NVIDIA Kubernetes Engine (NVKE) und NVIDIA Kubernetes Recipes (NVKR) als Open Source veröffentlicht, um Managed Kubernetes auf GPU-Infrastruktur zu betreiben. Was sie einfach erklärt leisten, was Public Preview wirklich bedeutet, warum KI-Engineering neue Nachfrage nach Cloud- und DevOps-Kompetenzen schafft und wer sie jetzt evaluieren sollte.
Balinder WaliaLesen 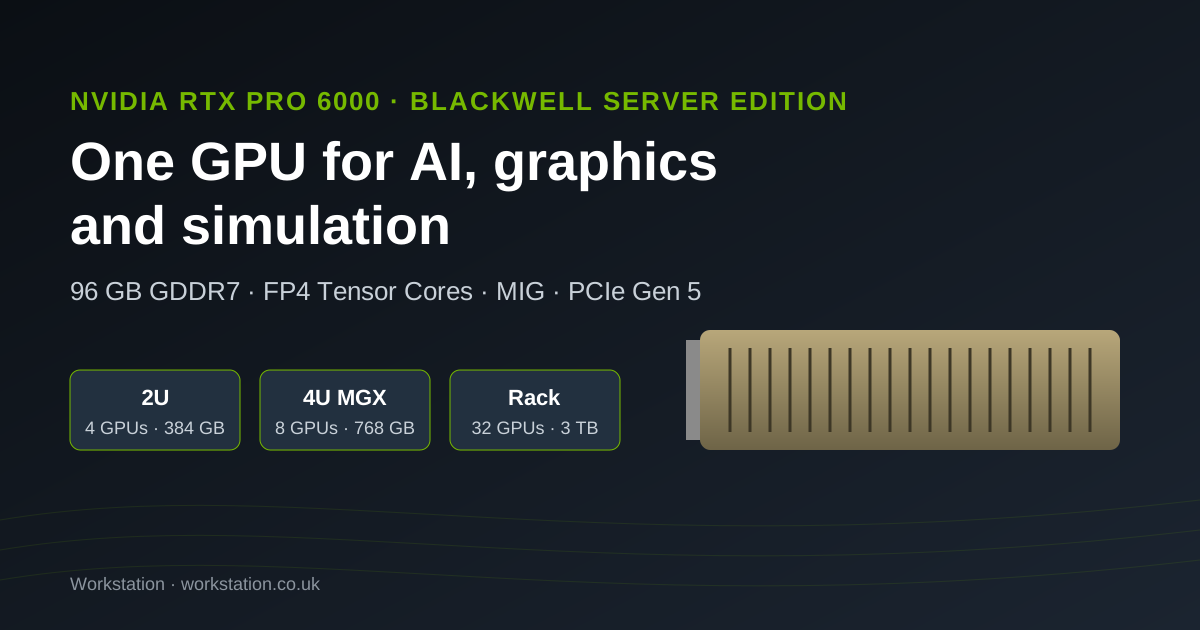
NVIDIA RTX PRO 6000 Blackwell Server Edition: Eine GPU für KI, Grafik und Simulation im britischen Serverraum
96 GB GDDR7, FP4-Tensor-Cores und RT-Cores auf einer Standard-PCIe-Karte: was NVIDIAs RTX PRO 6000 Blackwell Server Edition leistet, warum sie zu Unternehmen passt, die private KI in bereits vorhandenen Räumen betreiben, die drei Systemgrößen vom 2U-Server mit vier GPUs bis zum Rack mit 32 GPUs wie AMAX' RackScale 32 und was Sie vor der Bestellung prüfen sollten.
Balinder WaliaLesen 
Aus der Halle der GTC Berlin: Huang sagt, KI ist jetzt produktiv
Workstation-Ingenieure waren am 21. Oktober 2026 zur Keynote in der STATION-Berlin. Huangs Wende führte von Fabriken zu Agenten, die Tokens verbrauchen.
Balinder WaliaLesen OpenShell, vorgestellt auf der GTC Berlin: Richtlinien außerhalb des Agenten
Huangs Sicherheitsfilm verwarf „Bitte nicht“ als Kontrollmechanismus. OpenShell setzt eine Richtlinie für Systemaufrufe, Dateien und Netzwerk durch, mit Sentry auf BlueField-4.
Balinder WaliaLesen 
Die Berliner Folie, die Dokumente von Datenbanken trennt
Nemotron Parse, Embed, cuVS und Rerank in einer Reihe. Auto-Ontology, cuDF und Kumo in der anderen. Huangs Beispiel mit dem Lieferverzug nutzt beide.
Balinder WaliaLesen 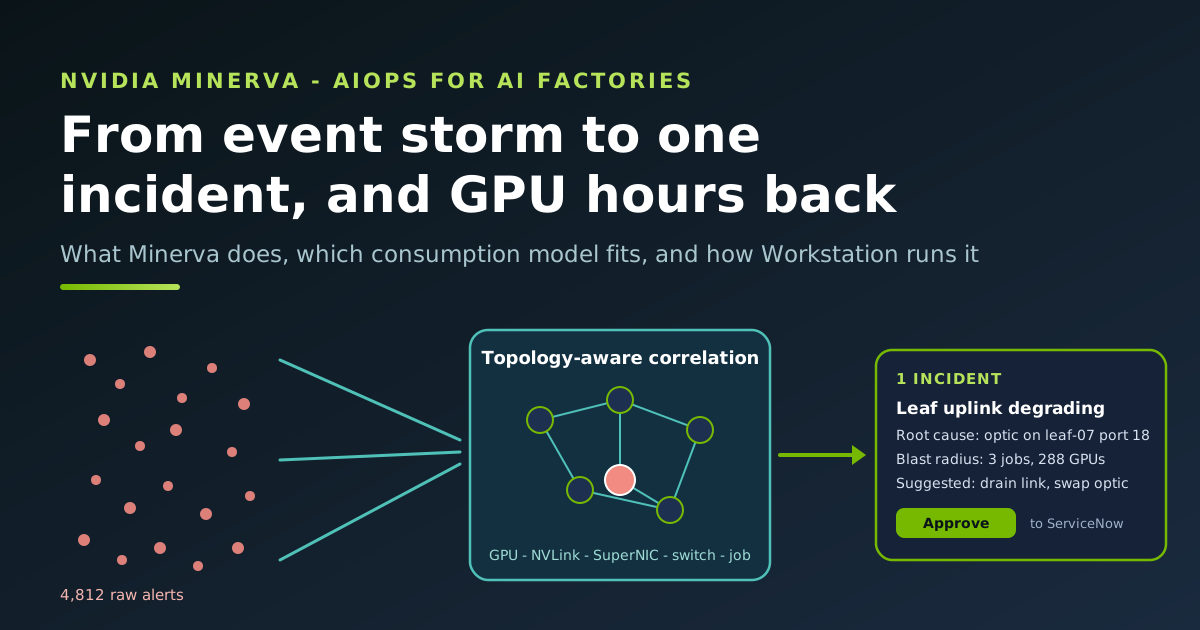
DSX, das CUDA-Rad und Europas KI-Stack auf der GTC Berlin
Huangs Fabrikhälfte: DSX ausgehend von einem digitalen Zwilling, Vera-Rubin-Pods und eine Folie, die Anwendungen, Modelle, Fabriken, NVIDIA-Rechenleistung und Energie übereinanderstapelt.
Balinder WaliaLesen NVIDIA Minerva für KI-Fabriken: Aus Alarmstürmen werden zurückgewonnene GPU-Stunden
Eine einzige nachlassende Optik kann Tausende von Alarmen auslösen und tausend GPUs ausbremsen. Was NVIDIA Minerva leistet, was es in GPU-Stunden, Goodput, MTBI, MTTR und Tokens wert ist, welches seiner drei Nutzungsmodelle passt, durchgerechnete Beispiele für eine Neocloud mit Vera Rubin NVL72, einen Blackwell-Cluster an einer Universität und ein Unternehmen mit Grafana und ServiceNow sowie das Verhältnis zu UFM.
Balinder WaliaLesen 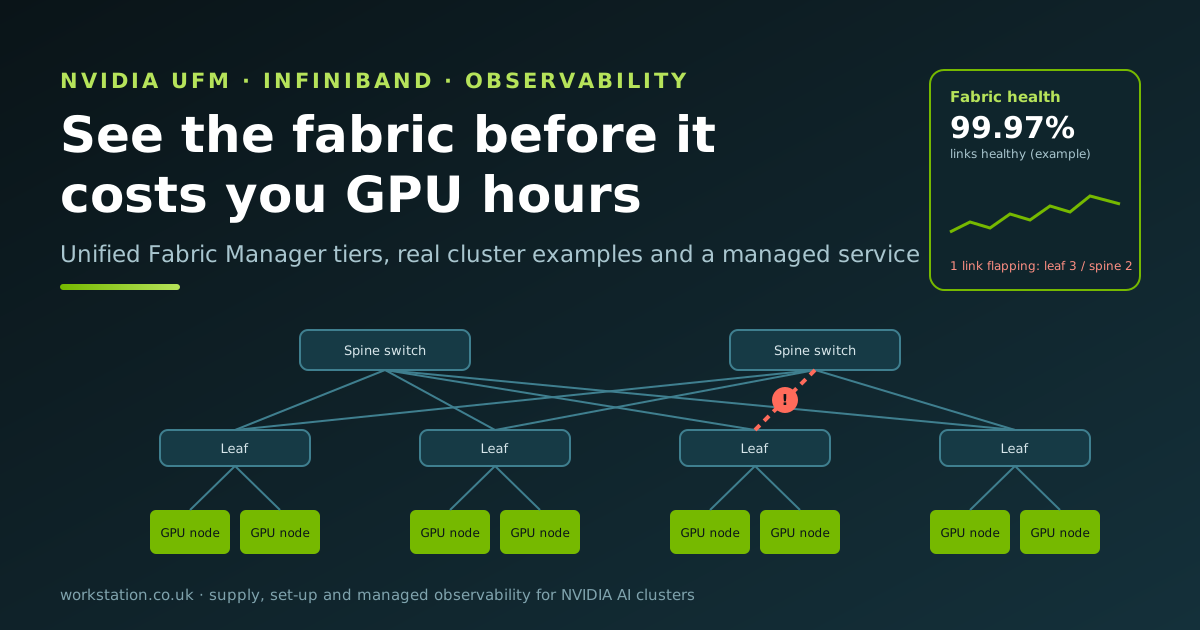
NVIDIA UFM für KI-Cluster: Warum die Sichtbarkeit des InfiniBand-Fabrics bestimmt, was Ihre GPUs wert sind
Ein einziger flatternder InfiniBand-Link kann einen Job mit 256 GPUs ausbremsen. Was NVIDIA Unified Fabric Manager leistet, wann UFM Telemetry, Enterprise oder Cyber-AI passt, durchgerechnete Beispiele für einen DGX-B300-Cluster mit 4 Knoten, einen Cluster im SuperPOD-Stil mit 32 Knoten und einen Slurm-Dienst an einer Universität sowie was Fabric-Sichtbarkeit in GPU-Stunden wert ist.
Balinder WaliaLesen 
NVIDIA Blackwell Ultra B300 ist in Großbritannien angekommen: Konfigurieren Sie Ihr System noch heute
NVIDIA-Blackwell-Ultra-B300-Systeme sind bei unseren britischen Distributionspartnern eingetroffen. Konfigurieren und kalkulieren Sie Ihr B300-System mit acht GPUs in wenigen Minuten mit unserem KI-Vertriebsingenieur, sparen Sie mit Workstation Trade und bestellen Sie noch heute, um bei der Auslieferung in Großbritannien ganz vorne in der Reihe zu stehen.
Balinder WaliaLesen