KI-Wissensdatenbank · KI-Cloud-Plattformen
Jede KI-Cloud, ein Team, das sie alle kennt
Hyperscaler für verwaltete Modelle und Enterprise-Kontrollen, GPU-Clouds für reine Kapazität, Marktplätze für die günstigsten Stunden. Das Workstation-Team entwirft, sichert und betreibt KI auf allen davon — und neben der Hardware, die Sie besitzen.
Hyperscaler
Amazon Web Services
Amazon Bedrock, SageMaker AI und das breiteste Angebot an GPUs und eigenen Chips.
Leitfaden lesen →
Google Cloud
Vertex AI, Gemini und TPUs neben NVIDIA-GPUs.
Leitfaden lesen →
Microsoft Azure
Azure OpenAI und AI Foundry, eingebunden in Microsoft 365 und Entra ID.
Leitfaden lesen →
Oracle Cloud Infrastructure
Bare-Metal-GPU-Supercluster und OCI Generative AI.
Leitfaden lesen →GPU-Clouds
CoreWeave
Eine Kubernetes-native Cloud für große GPU-Cluster.
Leitfaden lesen →Lambda
Einfache, schnelle GPU-Instanzen und -Cluster für KI-Teams.
Leitfaden lesen →Nebius
Eine Full-Stack-KI-Cloud mit GPU-Clustern und verwalteter Inferenz.
Leitfaden lesen →
DigitalOcean
Entwicklerfreundliche GPU Droplets und eine Agentenplattform.
Leitfaden lesen →GPU-Marktplätze
Ebenfalls unterstützt: Together AI, Fireworks AI, Groq, Hugging Face Inference Endpoints, Replicate, Crusoe, Hyperstack, Scaleway und OVHcloud.
Wie sie sich vergleichen
Die meisten Organisationen nutzen mehr als eine: einen Hyperscaler für verwaltete Modelle und Governance, eine GPU-Cloud für Training oder intensive Inferenz und eigene Hardware für sensible oder gleichmäßige Workloads.
| Typ | Stärken | Kompromisse | Einsatz für |
|---|---|---|---|
| Hyperscaler (AWS, Google Cloud, Azure, Oracle) | Verwaltete Modelle, Identität, Compliance, globale Regionen | Höhere GPU-Preise, Kontingente müssen verwaltet werden | Produktive APIs, regulierte Daten, verwaltete Agenten |
| GPU-Clouds (CoreWeave, Lambda, Nebius, DigitalOcean) | Neueste GPUs, große Cluster, einfachere Preise | Weniger verwaltete Dienste | Training, Fine-Tuning, Inferenz mit hohem Volumen |
| GPU-Marktplätze (Vast.ai, RunPod) | Niedrigste Kosten pro GPU-Stunde, schneller Start | Schwankende Zuverlässigkeit und Vertrauenswürdigkeit | Experimente, Batch-Jobs, Endpunkte mit Skalierung auf null |
| Ihre eigene Workstation-Hardware | Fixkosten, volle Kontrolle, Daten bleiben in Ihrem Gebäude | Investitionsaufwand, Kapazitätsplanung | Sensible Daten, gleichmäßige Workloads, Entwicklung |
KI im großen Maßstab skalieren mit Amazon Bedrock
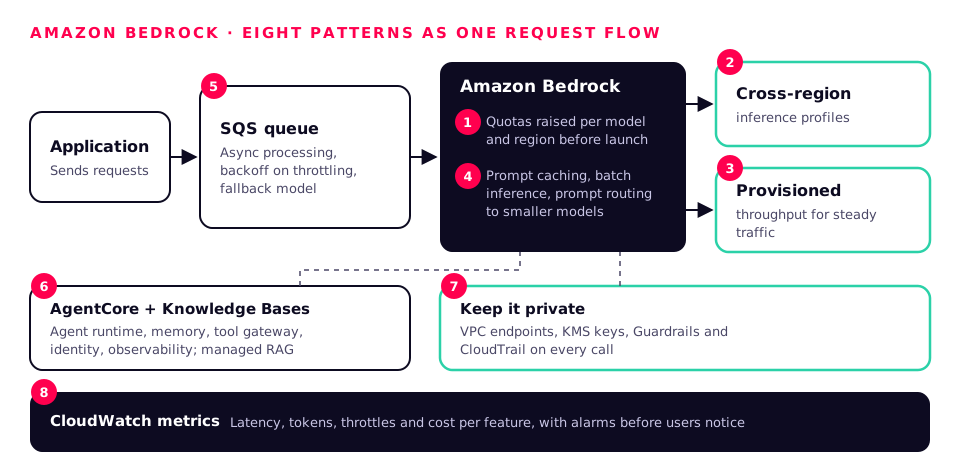
Bedrock löst das GPU-Problem, aber Verkehr im großen Maßstab muss trotzdem durchdacht werden. Diese Muster nutzen wir für Bedrock-Workloads mit hohem Volumen.
- 1
Kontingente zuerst planen
Modellieren Sie Tokens pro Minute und Anfragen pro Minute gegen Spitzenverkehr und erhöhen Sie Kontingente vor dem Launch, pro Modell und pro Region.
- 2
Last verteilen
Regionsübergreifende Inferenzprofile leiten Anfragen automatisch über Regionen hinweg, wenn eine ausgelastet ist.
- 3
Kapazität garantieren
Provisioned Throughput für gleichmäßigen, latenzkritischen Verkehr; On-Demand für den Rest.
- 4
Kosten pro Anfrage senken
Prompt-Caching für wiederholten Kontext, Batch-Inferenz für Offline-Arbeit und Prompt-Routing, um einfache Anfragen an kleinere Modelle zu senden.
- 5
Spitzen abfangen
Anfragen in eine Warteschlange stellen (SQS) und asynchron verarbeiten, mit exponentiellem Backoff bei Drosselung und einem Fallback-Modell.
- 6
Agenten richtig betreiben
Bedrock AgentCore für Agenten-Runtime, Memory, Tool-Gateway, Identität und Observability; Knowledge Bases für verwaltetes RAG.
- 7
Privat halten
VPC-Endpunkte, KMS-Schlüssel, Guardrails und CloudTrail bei jedem Aufruf.
- 8
Alles messen
CloudWatch-Metriken für Latenz, Tokens, Drosselungen und Kosten pro Funktion, mit Alarmen, bevor Benutzer etwas bemerken.
CI/CD für LLMs, Agenten und Daten in der Cloud
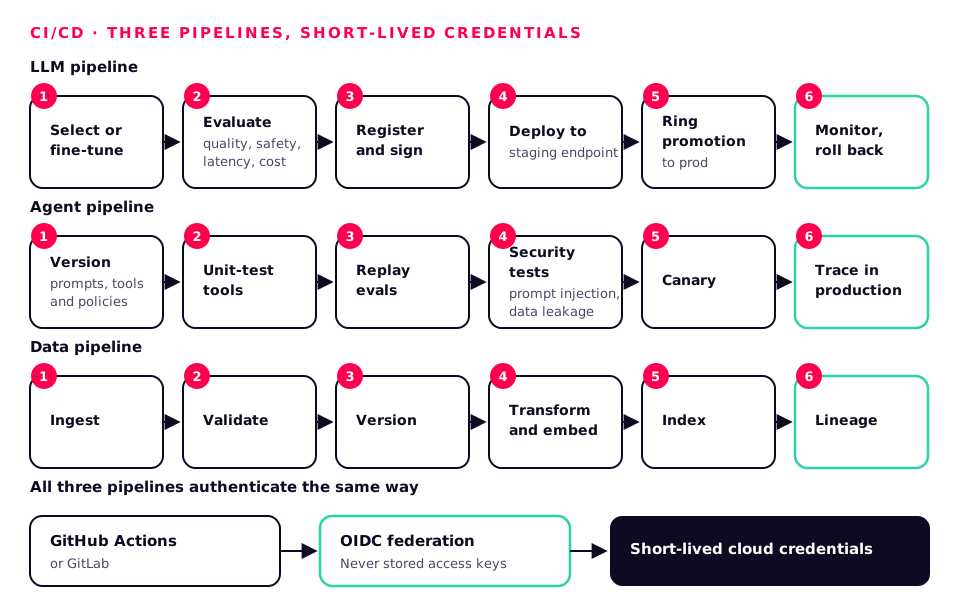
Die gleiche Disziplin wie On-Premises: alles versioniert, getestet, signiert und über Ringe ausgerollt, mit Infrastructure as Code, damit jede Umgebung reproduzierbar ist.
LLM-Pipeline
- Auswählen oder fine-tunen
- Evaluieren (Qualität, Sicherheit, Latenz, Kosten)
- Registrieren und signieren
- Auf Staging-Endpunkt bereitstellen
- Ring-Promotion in die Produktion
- Überwachen und zurückrollen
Evaluierung mit Bedrock, Vertex AI oder Azure AI Foundry; SageMaker- oder Vertex-Pipelines; MLflow-Registry; Terraform oder OpenTofu; Ring Promoter für Releases mit Health-Checks.
Agenten-Pipeline
- Prompts, Tools und Richtlinien versionieren
- Tools unit-testen
- Evals wiederholen
- Sicherheitstests (Prompt-Injection, Datenabfluss)
- Canary
- Tracing in der Produktion
AgentCore, Agent Engine oder Foundry Agent Service; OpenTelemetry-Tracing; Evaluierungssuiten in CI.
Daten-Pipeline
- Aufnehmen
- Validieren
- Versionieren
- Transformieren und einbetten
- Indexieren
- Lineage
AWS Glue, Dataflow oder Data Factory; Airflow oder Dagster; Bedrock Knowledge Bases, Vertex AI Search oder Azure AI Search; OpenLineage.
Pipelines laufen mit kurzlebigen Cloud-Anmeldedaten über OIDC-Föderation aus GitHub Actions oder GitLab, niemals mit gespeicherten Zugriffsschlüsseln.
LLM- und Agenten-APIs absichern
Ein LLM-Endpunkt ist eine API, der man Dinge einreden kann. Wir sichern ihn wie jede kritische API ab und ergänzen dann die KI-spezifischen Kontrollen.
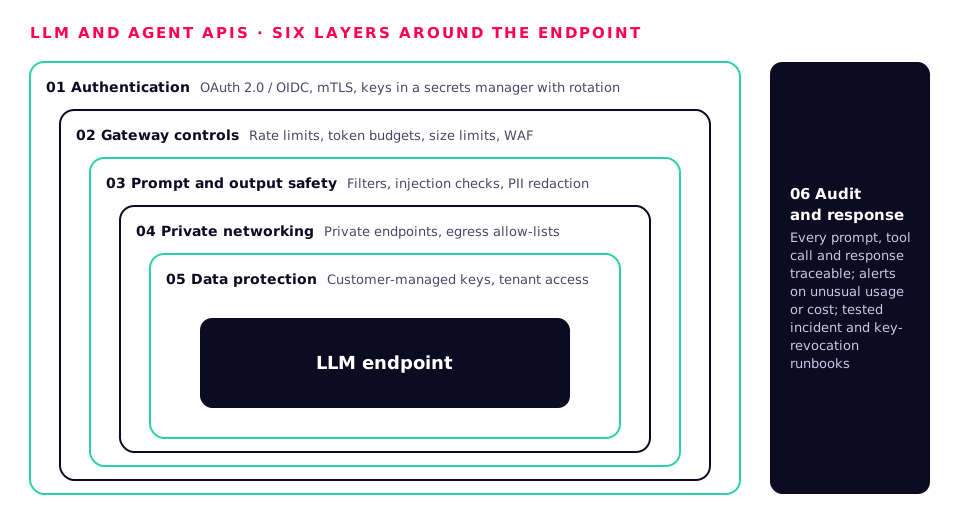
01
Authentifizierung
- OAuth 2.0 / OIDC für Benutzer und Dienste
- mTLS zwischen Diensten
- Keine statischen API-Schlüssel im Code; Schlüssel in einem Secrets-Manager mit Rotation
02
Gateway-Kontrollen
- Ratenlimits und Token-Budgets pro Benutzer und Mandant
- Grenzen für Anfragegröße und Kontext
- WAF vor öffentlichen Endpunkten
03
Prompt- und Ausgabesicherheit
- Guardrails, Model Armor oder Content Safety bei Ein- und Ausgabe
- Erkennung von Prompt-Injection in abgerufenen Dokumenten und Tool-Ergebnissen
- Schwärzung personenbezogener Daten vor dem Logging
04
Privates Netzwerk
- Private Endpunkte für Modell-APIs
- Egress-Allow-Lists für Agenten und Tools
- Keine öffentlichen IPs auf Modellservern
05
Datenschutz
- Kundenverwaltete Schlüssel
- Zugriff auf Mandanten- und Dokumentebene beim Retrieval
- Datenresidenz in UK- oder EU-Regionen, wo erforderlich
06
Audit und Reaktion
- Jeder Prompt, jeder Tool-Aufruf und jede Antwort nachvollziehbar
- Alarme bei ungewöhnlicher Nutzung oder ungewöhnlichen Kosten
- Getestete Runbooks für Vorfälle und Schlüsselwiderruf
Der KI-Agenten-Harness
Ein Agent ist ein Modell plus ein Harness: der Code, der entscheidet, was er sehen darf, welche Tools er aufrufen darf und wann ein Mensch zustimmen muss. Im Harness liegen Sicherheit und Zuverlässigkeit.
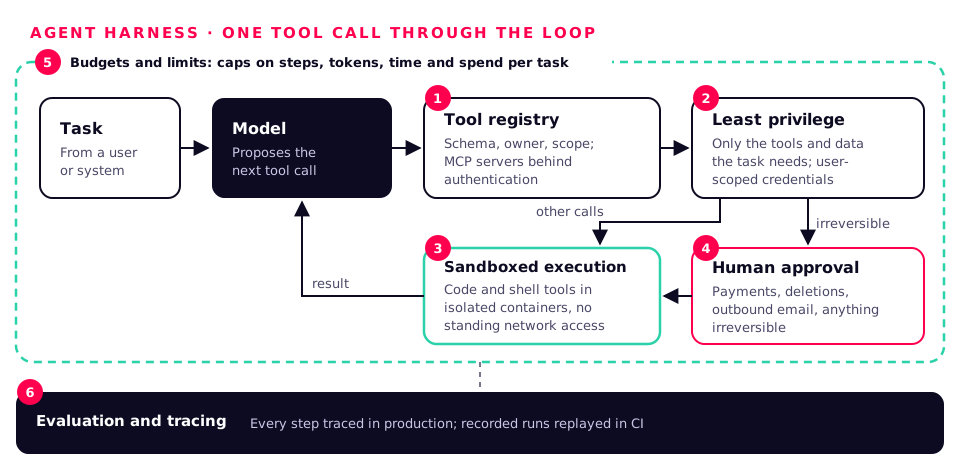
Tool-Registry
Jedes Tool mit Schema, Verantwortlichem und Berechtigungsbereich deklariert; MCP-Server hinter Authentifizierung.
Least Privilege
Jeder Agent erhält nur die Tools und Daten, die seine Aufgabe erfordert, mit Anmeldedaten, die auf den Benutzer beschränkt sind, für den er handelt.
Ausführung in der Sandbox
Code- und Shell-Tools laufen in isolierten Containern ohne dauerhaften Netzwerkzugriff.
Mensch in der Schleife
Freigaben für Zahlungen, Löschungen, ausgehende E-Mails und alles Irreversible.
Budgets und Limits
Obergrenzen für Schritte, Tokens, Zeit und Ausgaben pro Aufgabe, mit sauberem Abbruch bei Erreichen.
Evaluierung und Tracing
Aufgezeichnete Läufe werden in CI wiederholt, und jeder Schritt wird in der Produktion für Debugging und Audit nachverfolgt.
Identität und Authentifizierung für KI
Agenten handeln im Auftrag von Menschen und Systemen, daher brauchen sie richtige Identitäten, keine gemeinsam genutzten Schlüssel.
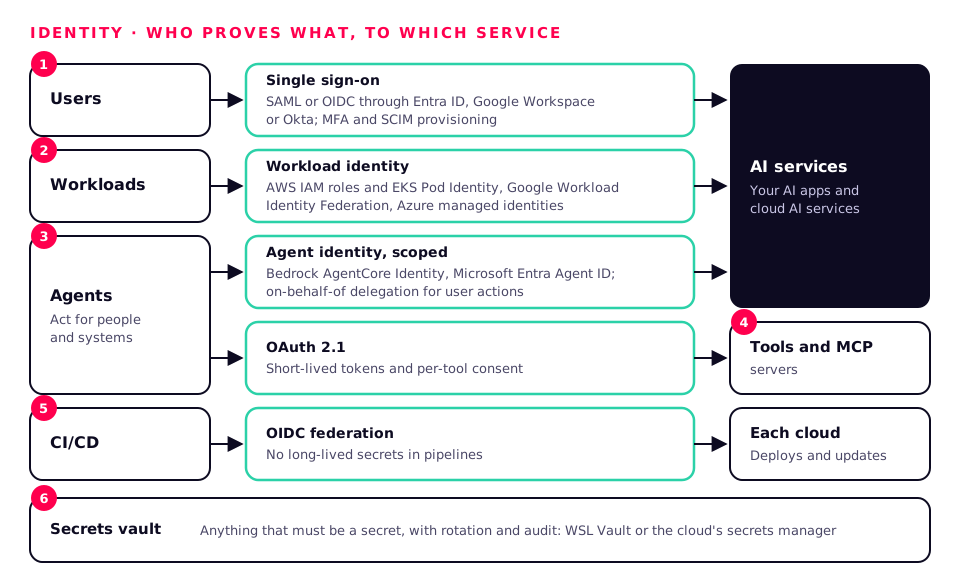
Benutzer
Single Sign-on über Ihren Identitätsanbieter (Entra ID, Google Workspace, Okta) mit SAML oder OIDC, MFA und SCIM-Provisionierung.
Workloads
Cloud-native Workload Identity: AWS-IAM-Rollen und EKS Pod Identity, Google Workload Identity Federation, verwaltete Azure-Identitäten.
Agenten
Agenten-Identitäten mit eigenen, eingeschränkten Berechtigungen, etwa Bedrock AgentCore Identity und Microsoft Entra Agent ID, mit On-Behalf-of-Delegierung für Benutzeraktionen.
Tools und MCP
OAuth 2.1 für MCP-Server und Drittanbieter-Tools, kurzlebige Tokens und Zustimmung pro Tool.
CI/CD
OIDC-Föderation von Ihrer CI zu jeder Cloud, damit Pipelines keine langlebigen Secrets halten.
Secrets
Ein Vault für alles, was ein Secret sein muss, mit Rotation und Audit, etwa unser WSL Vault oder der eigene Secrets-Manager der Cloud.
KI-Workloads in der Cloud optimieren
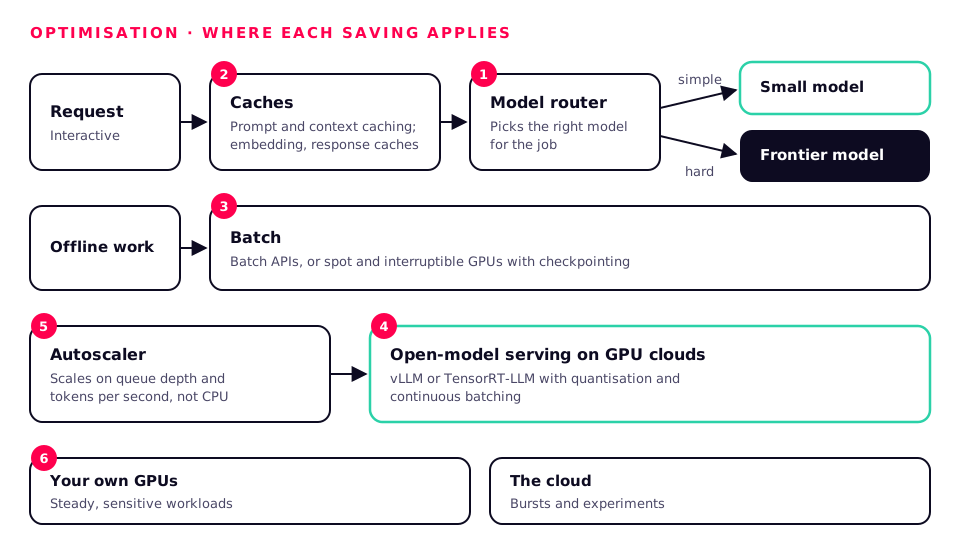
- Das richtige Modell für die Aufgabe: einfache Anfragen an kleine Modelle leiten und Frontier-Modelle für schwierige aufsparen.
- Cachen Sie alles, was möglich ist: Prompt- und Kontext-Caching, Embedding-Caches und Antwort-Caches für wiederkehrende Fragen.
- Offline-Arbeit bündeln: Batch-APIs und Spot- oder unterbrechbare GPUs mit Checkpointing.
- Offene Modelle effizient bereitstellen: vLLM oder TensorRT-LLM mit Quantisierung und Continuous Batching auf GPU-Clouds.
- Nach dem richtigen Signal autoskalieren: Warteschlangentiefe und Tokens pro Sekunde, nicht CPU.
- Hybrid by Design: gleichmäßige, sensible Workloads auf Ihren eigenen GPUs, Lastspitzen und Experimente in der Cloud.
Unterstützt vom Workstation-Team
Wir sind plattformneutral. Wir helfen Ihnen bei der Auswahl und entwerfen, sichern, implementieren und betreiben KI dann auf jeder dieser Clouds, neben Ihrer eigenen Hardware.
- Architektur und Plattformauswahl, einschließlich Kostenmodellierung
- Landing Zones mit Identität, Netzwerk und Verschlüsselung
- Lösungen und Agenten mit Bedrock, Vertex AI und Azure AI Foundry
- Aufbau von GPU-Clustern auf GPU-Clouds
- CI/CD, Evaluierung und ringbasierte Releases
- Sicherheitsprüfungen von LLM- und Agenten-APIs
- Hybride Setups mit On-Premises-Workstation-Hardware
Logos sind Marken ihrer jeweiligen Inhaber, werden nur zur Kennzeichnung der jeweiligen Plattform verwendet und stammen von Wikimedia Commons. Diagramme vom Workstation-Team.