Der Shop ist online

Wir bauen Workstation AI-Maschinen für Websites, KI-Agenten und LLM-Training – online konfigurieren und kaufen.

Händlerpreise erhalten
KI-Produkte
KI-LabsOpenAI-AgentenClaude-AgentenGrok-BotWorkstation AI-natives CRMMarketingAlle Produkte
KI-Lösungen
Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI-WorkstationsNVIDIA-Hardware & -SoftwareNVIDIA Accelerated ComputingPrivate KIGPU-Private-CloudGPU-ClusterEdge-KIKI nach Branche
KI-Services
PlattformmodernisierungDigital EngineeringDatengrundlagen & KIAutonomer BetriebKI-BeratungDevOps-AutomatisierungCybersicherheitSoftwareentwicklungAgentenentwicklungMLOps-EinrichtungGPU-LeasingGPU-Private-Cloud
Über uns
UnternehmenUnsere GeschichtePartnerKundengeschichten
KI-Rechenzentren
KI-RechenzentrenGPU-Private-CloudGPU-ClusterGPU-Leasing
KI-EinblickeJev-ReiheBenchmark LabModellauswahl
Technische Hinweise
Dokumentation
Linux-BetriebssystemeUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
KI-Cloud-PlattformenAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-Clouds & Marktplätze
Private KI-RechenzentrenFür AnwaltskanzleienFür Steuer- und WirtschaftsprüfungskanzleienOn-Premises-PlattformenVollständig abgesicherte Cloud
ToolsRing PromoterJobshout
News
Blog
KontaktAnmelden

KI-Workstations, Multi-Agenten-KI-Software, GPU-Infrastruktur und intelligente Agentenlösungen für moderne Unternehmen.

Kontakt

KI-Lösungen

Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI nach Branche

Produkte

Alle ProdukteWorkstation AI-natives CRM & ERPMarketingOpenAI-AgentenRing PromoterJobshout

Unternehmen

Über unsUnternehmenKI-RechenzentrenWarum WorkstationPartnerKundengeschichtenPreiseKontaktTenthMatrix

Ressourcen

KI-EinblickeTechnische HinweiseDokumentationLinux-BetriebssystemeKI-Cloud-PlattformenPrivate KI-RechenzentrenBlogSucheSitemap
Büro Belgien
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Mo – Fr: 9:00 – 18:00 Uhr MEZ
+32 492 45 67 46
Hauptsitz Großbritannien
77-79 Marlowes, Hemel Hempstead HP1 1LFAnfahrt – Ausfahrt 20 der M25 (Outer London)Handelsregisternr.: 11641870Mo – Fr: 9:00 – 18:00 Uhr GMT
+44 7515 356 146
Büro Indien
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Büro Taiwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Mo – Fr: 9:00 – 18:00 Uhr Taiwan-Zeit (GMT+8)
+886 926 892 701+32 492 45 67 46
Büro Estland
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaMo - Fr: 9:00 - 18:00 Uhr estnischer Zeit (EET)
+32 492 45 67 46

© 2026 Workstation AI. Alle Rechte vorbehalten.

DatenschutzDatenlöschungCookiesNutzungsbedingungenWebsite-Sitemap

NVIDIA, das NVIDIA-Logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX und HGX sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den USA und anderen Ländern. AMD, das AMD-Arrow-Logo, EPYC, Instinct, Ryzen und Threadripper sind Marken von Advanced Micro Devices, Inc. Dell und PowerEdge sind Marken der Dell Inc. oder ihrer Tochtergesellschaften. Intel und Xeon sind Marken der Intel Corporation oder ihrer Tochtergesellschaften. AMAX, AceleMax und LiquidMax sind Marken der AMAX Engineering Corporation. Alle anderen Produktnamen, Logos und Marken sind Eigentum ihrer jeweiligen Inhaber. Wir verwenden sie ausschließlich, um die Produkte zu kennzeichnen, die wir beschreiben, liefern oder unterstützen; ihre Verwendung bedeutet nicht, dass ihre Inhaber uns empfehlen.

Einblicke & Leitfäden

Technische Hinweise

Deep Dives zu KI-Infrastruktur, MLOps, GPU-Clustern und der Entwicklung mit Agenten.
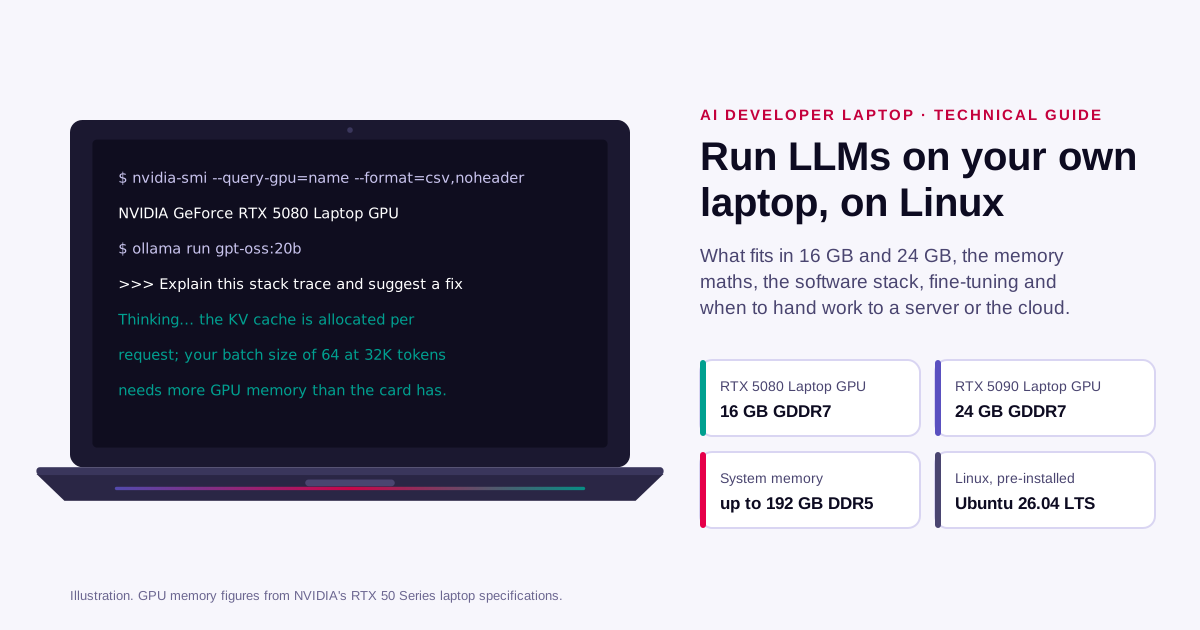
Laptops für KI-Entwickler: LLMs lokal unter Linux mit GPUs mit 16 GB und 24 GB betreiben (Leitfaden 2026)
AI•18. Nov. 2026

Laptops für KI-Entwickler: LLMs lokal unter Linux mit GPUs mit 16 GB und 24 GB betreiben (Leitfaden 2026)

Was auf eine RTX 5080 oder RTX 5090 Laptop GPU passt, die Speicherrechnung, die lohnenden offenen Modelle, die Einrichtung von Ubuntu 26.04 mit dem N…

15 min readWeiterlesen
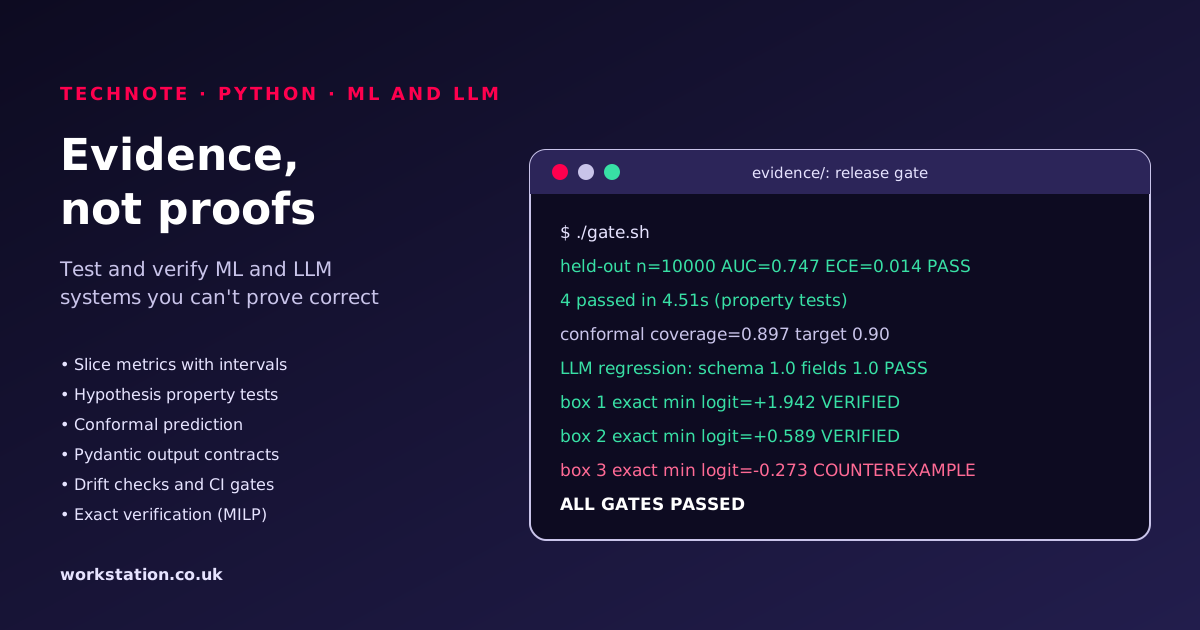
ML- und LLM-Systeme testen, deren Korrektheit sich nicht beweisen lässt: ein Python-Evidenz-Kit
AI•16. Nov. 2026

ML- und LLM-Systeme testen, deren Korrektheit sich nicht beweisen lässt: ein Python-Evidenz-Kit

Evidenz statt Beweise, in etwa 400 Zeilen Python mit echter Ausgabe: Slice-Metriken mit Bootstrap-Intervallen und einem Pass/Fail-Vertrag, Property-…

27 min readWeiterlesen
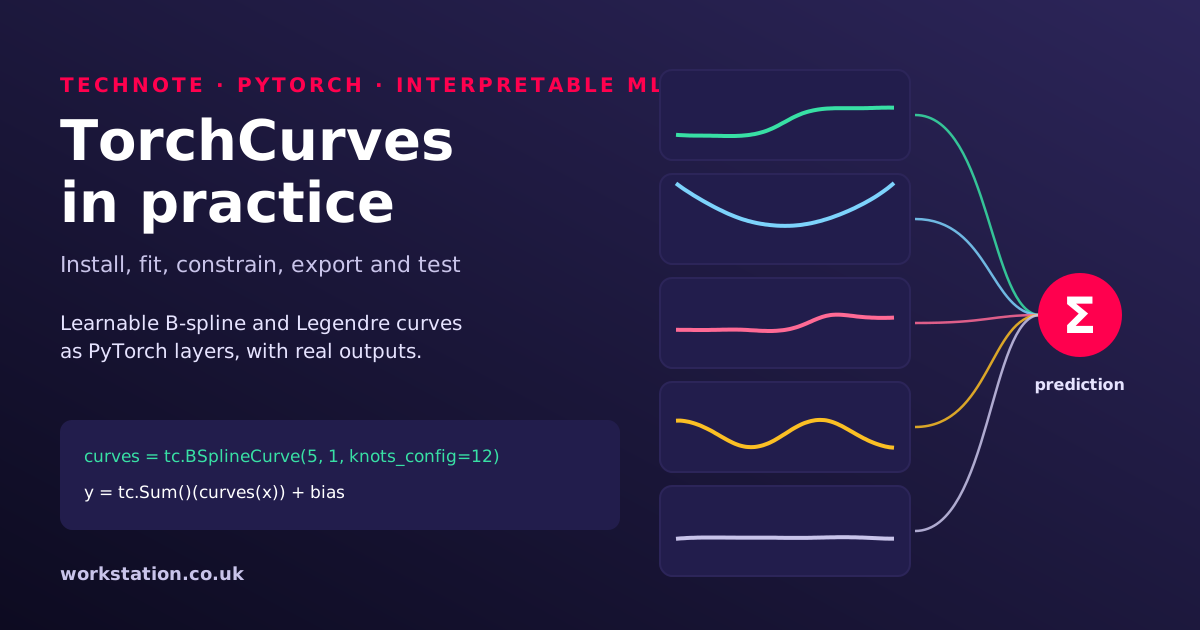
TorchCurves in der Praxis: lernbare B-Spline- und Legendre-Kurven in PyTorch
AI•16. Nov. 2026

TorchCurves in der Praxis: lernbare B-Spline- und Legendre-Kurven in PyTorch

torchcurves installieren, eine Kurve anpassen und dimensionieren, B-Spline oder Legendre und die Eingabeabbildung wählen, eine monotone Kalibrierungs…

25 min readWeiterlesen
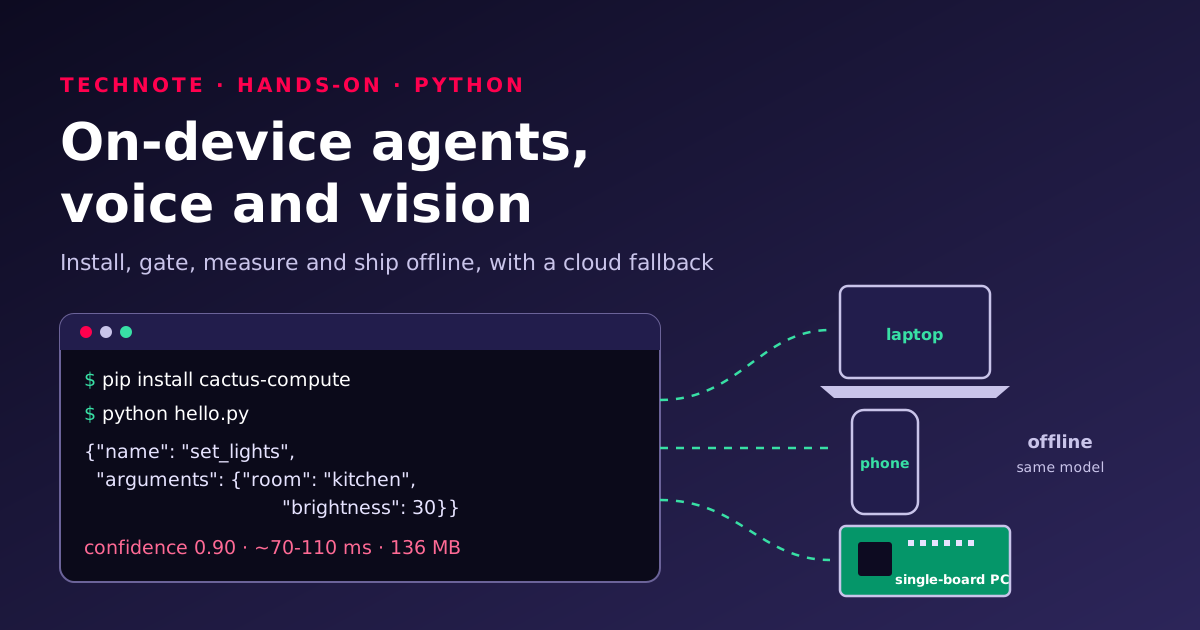
Agentische, Sprach- und Bildmodelle auf dem Gerät mit Cactus betreiben: Ein Praxisleitfaden (2026)
AI•16. Nov. 2026

Agentische, Sprach- und Bildmodelle auf dem Gerät mit Cactus betreiben: Ein Praxisleitfaden (2026)

cactus-compute installieren, Tool-Calls ausführen, per Konfidenzschwelle mit Rückfall auf ein größeres Modell absichern, strukturierte Daten extrahie…

22 min readWeiterlesen
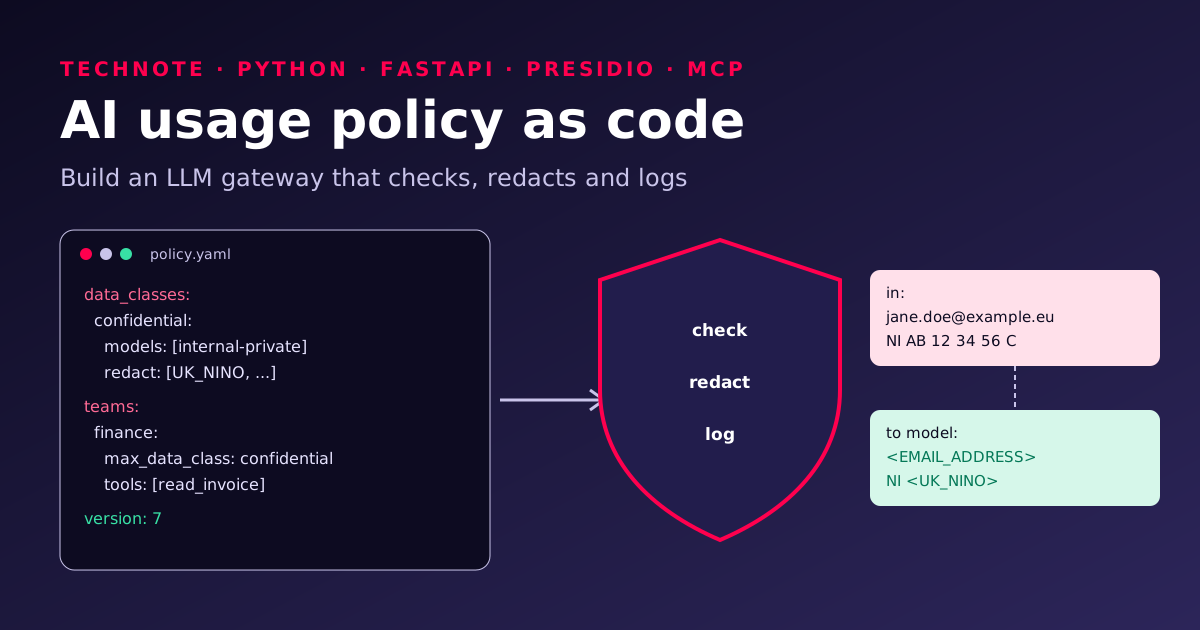
KI-Nutzungsrichtlinie als Code: ein LLM-Gateway mit PII-Schwärzung, Tool-Allow-Lists und Telemetrie bauen
AI•16. Nov. 2026

KI-Nutzungsrichtlinie als Code: ein LLM-Gateway mit PII-Schwärzung, Tool-Allow-Lists und Telemetrie bauen

Die KI-Anleitungslücke im Code schließen: eine versionierte Richtliniendatei, ein OpenAI-kompatibles FastAPI-Gateway, Schwärzung mit Presidio, Tool-…

29 min readWeiterlesen
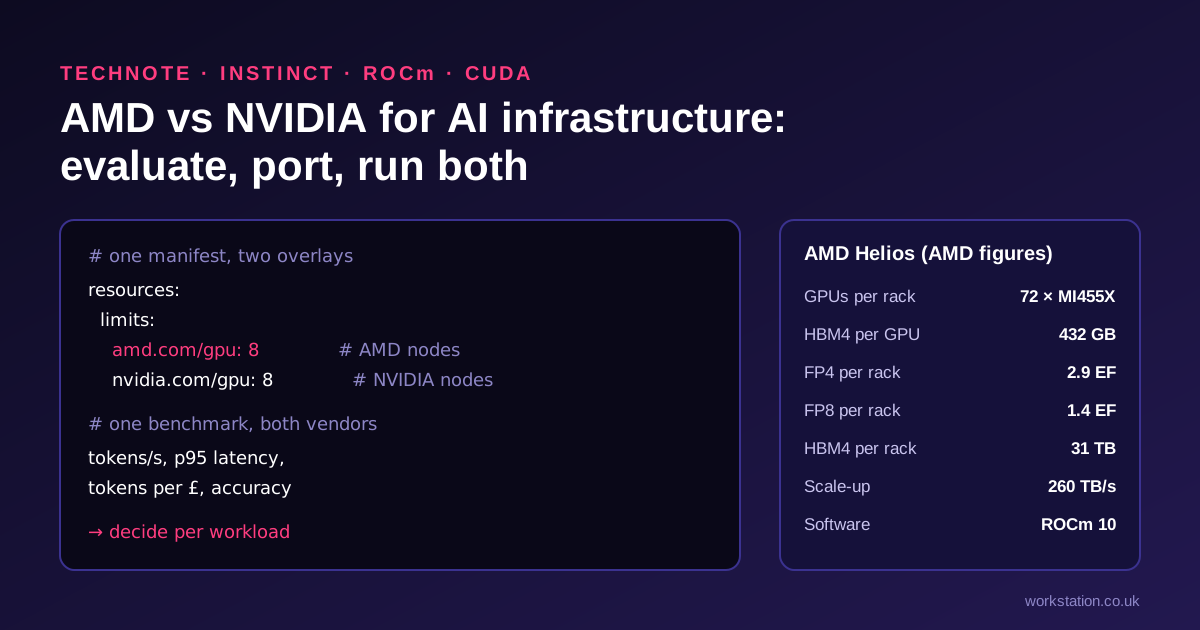
AMD Instinct vs. NVIDIA für KI-Infrastruktur: Evaluieren, portieren und beide betreiben (2026)
AI•14. Nov. 2026

AMD Instinct vs. NVIDIA für KI-Infrastruktur: Evaluieren, portieren und beide betreiben (2026)

Vom Interview mit Lisa Su 2024 bis Helios: die Plattformen von 2026 Schicht für Schicht, Instinct-Produktlinien, Speicherrechnung, die Software-Zuord…

11 min readWeiterlesen
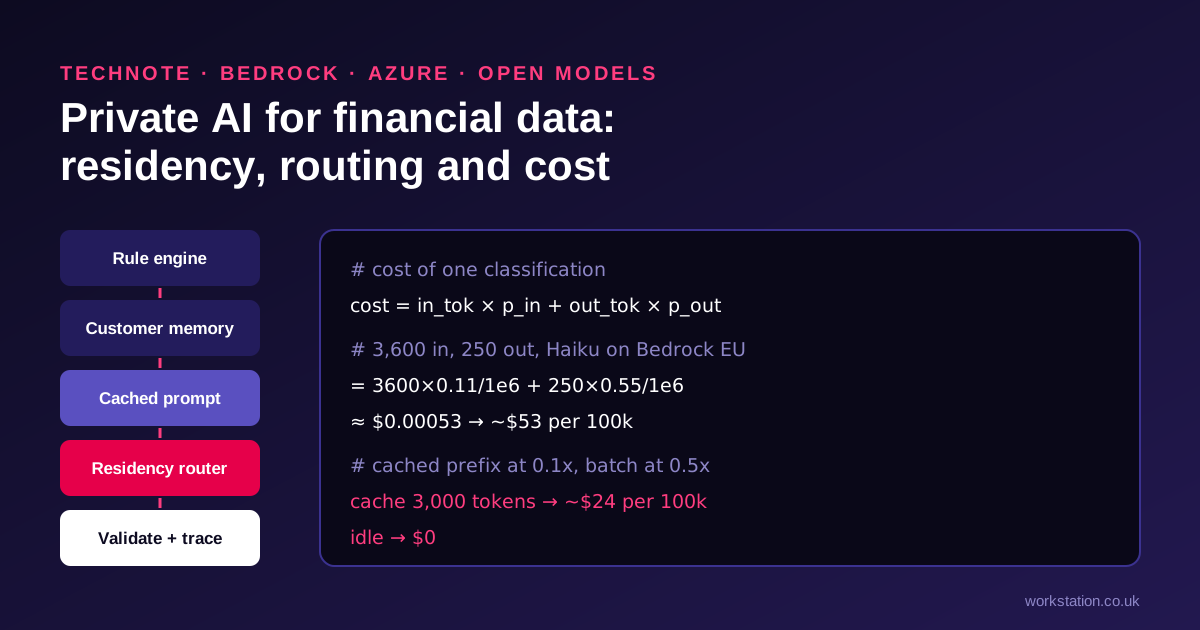
Private KI für Finanzdaten: Residency, Routing und Kosten auf AWS Bedrock, Microsoft Azure und eigenen GPUs
AI•14. Nov. 2026

Private KI für Finanzdaten: Residency, Routing und Kosten auf AWS Bedrock, Microsoft Azure und eigenen GPUs

Abrechnungsmodelle und Leerlaufkosten, Kosten pro Aufruf bei drei Volumina, Bedrock in-region vs. EU-Profile, Converse API mit Prompt-Caching und Reg…

17 min readWeiterlesen
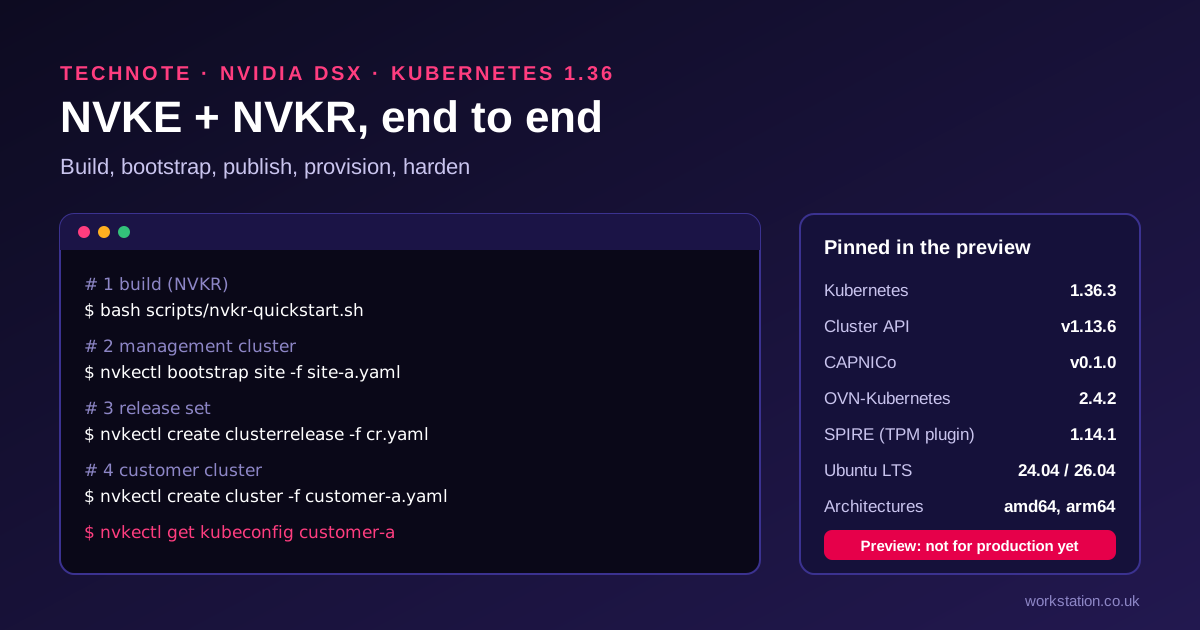
Technote zu NVKE und NVKR: Einen Managed-GPU-Kubernetes-Dienst ab Bare Metal aufbauen, mit reproduzierbaren, verifizierbaren Builds
AI•14. Nov. 2026

Technote zu NVKE und NVKR: Einen Managed-GPU-Kubernetes-Dienst ab Bare Metal aufbauen, mit reproduzierbaren, verifizierbaren Builds

Architektur, Komponenten und fixierte Versionen, der NVKR-Lebenszyklus aus Definition, Run, Release und Verify, der vollständige nvkectl-Ablauf von g…

21 min readWeiterlesen
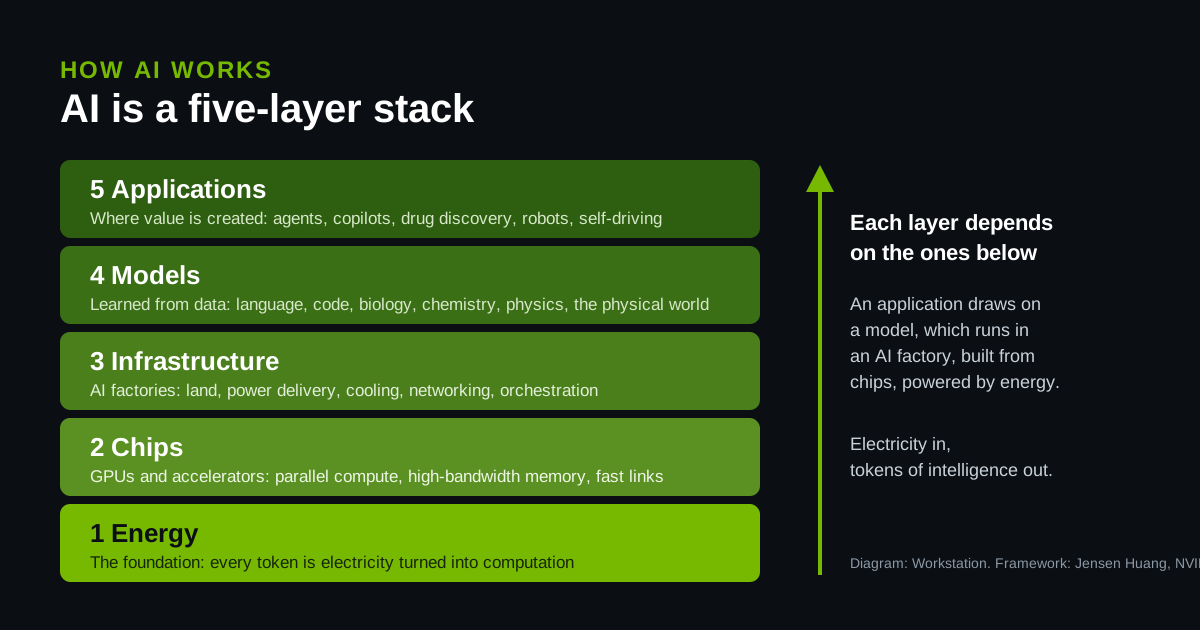
KI ist eine fünfschichtige Torte: Was KI ist, wie sie funktioniert und warum jede Schicht zählt
AI•13. Nov. 2026

KI ist eine fünfschichtige Torte: Was KI ist, wie sie funktioniert und warum jede Schicht zählt

Das Modell von Jensen Huang erklärt: Energie, Chips, Infrastruktur, Modelle und Anwendungen, wie jede Schicht von den darunterliegenden abhängt und w…

8 min readWeiterlesen
1