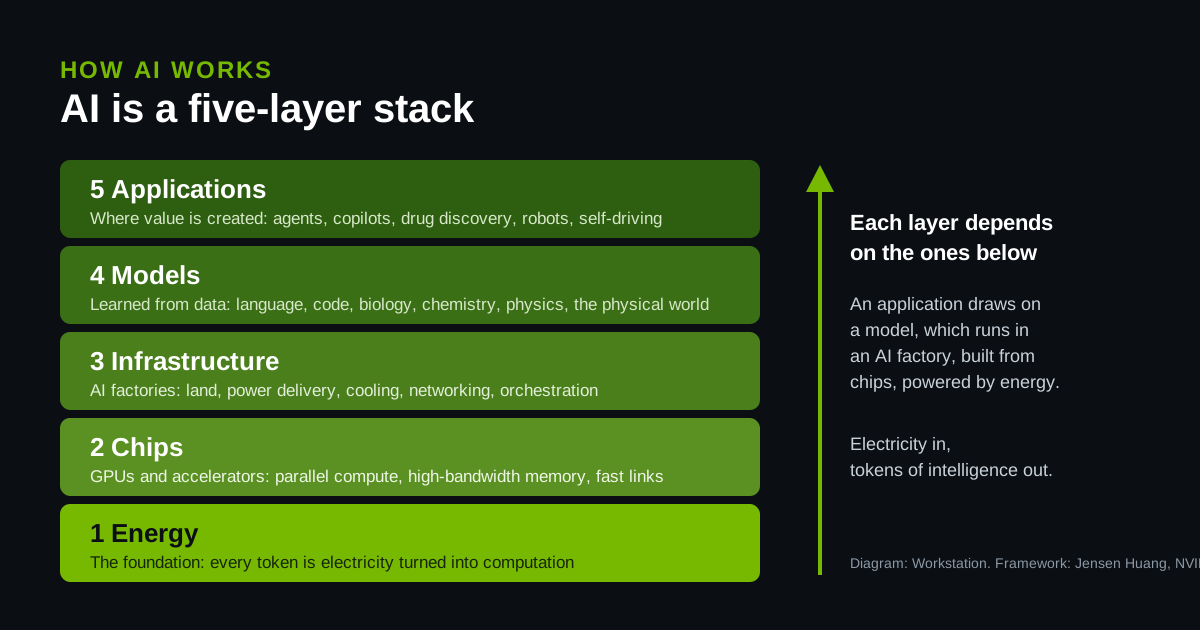
„KI“ steht für alles Mögliche, vom Chatbot über den Roboter bis zum Vertrag mit einem Kraftwerk, und ist deshalb schwer zu erklären. Jensen Huang, der Gründer von NVIDIA, hat eines der klarsten Bilder dafür geliefert: KI ist eine fünfschichtige Torte aus Energie, Chips, Infrastruktur, Modellen und Anwendungen. Er verwendete es im Januar 2026 auf dem Weltwirtschaftsforum in Davos und legte es im März in einem NVIDIA-Blogbeitrag, „AI Is a 5-Layer Cake“, dar. Diese Note erklärt, was KI ist, wie sie vom Kraftwerk bis zur App auf Ihrem Bildschirm funktioniert und warum jede Schicht für alle wichtig ist, die KI kaufen oder aufbauen. Das Modell und die Aussagen, die wir ihm zuschreiben, stammen von ihm; die Erläuterungen und die praktischen Empfehlungen stammen von uns.
Inhalt
- Was KI ist: vom Abrufen von Antworten zum Erzeugen von Antworten
- Schicht 1: Energie
- Schicht 2: Chips
- Schicht 3: Infrastruktur, die KI-Fabrik
- Schicht 4: Modelle
- Schicht 5: Anwendungen
- Warum die Schichten nur zusammen funktionieren
- Was das für Arbeitsplätze bedeutet
- Was das für Ihr Unternehmen bedeutet
1. Was KI ist: vom Abrufen von Antworten zum Erzeugen von Antworten
Den größten Teil der Computergeschichte wurde Software im Voraus geschrieben. Ein Mensch legte die Schritte fest, der Computer führte sie aus, und Daten wurden in ordentlichen Tabellen gespeichert, um sie mit präzisen Abfragen nachzuschlagen. Fragte man nach einer Datei, holte der Computer die Datei, die bereits vorhanden war.
KI funktioniert anders. Ein Modell lernt Muster aus riesigen Mengen an Beispielen: Text, Code, Bilder, Ton und zunehmend Proteine, Moleküle und Sensormesswerte aus der physischen Welt. Wenn Sie ihm eine Frage stellen, holt es keine gespeicherte Antwort. Es erzeugt eine neue, Stück für Stück, aus dem, was es gelernt hat, und aus dem Kontext, den Sie ihm gegeben haben. Diese Stücke heißen Tokens: Fragmente von Wörtern, Pixeln, Klängen oder jeder anderen Art von Daten.
Das ist Huangs Ausgangspunkt. Weil jede Antwort neu entsteht, genau in dem Moment, in dem sie gebraucht wird, benötigt KI Rechenleistung und Strom im Moment der Nutzung, nicht nur einen Ort zum Ablegen von Dateien. Deshalb beschreibt er KI nicht als App oder als einzelnes Modell, sondern als grundlegende Infrastruktur wie Elektrizität und das Internet, aufgebaut in fünf Schichten.
| Klassische Datenverarbeitung | KI | |
|---|---|---|
| Was der Computer tut | Führt Schritte aus, die ein Mensch geschrieben hat | Nutzt Muster, die er aus Daten gelernt hat |
| Daten, die er versteht | Strukturierte Tabellen und Felder | Text, Bilder, Ton, Video, Code, wissenschaftliche Daten |
| Wie er antwortet | Ruft etwas bereits Gespeichertes ab | Erzeugt eine neue Antwort für Ihren Kontext |
| Wo er läuft | Rechenzentren, gebaut zum Speichern und Ausliefern von Dateien | KI-Fabriken, gebaut zum Erzeugen von Tokens |
2. Schicht 1: Energie
Alles beginnt mit Strom. Jedes Token, das eine KI erzeugt, ist das Ergebnis davon, dass Strom in Rechenleistung umgewandelt und Wärme abgeführt wird. Huang nennt Energie das erste Prinzip der KI-Infrastruktur und die entscheidende Grenze: Sie legt die Obergrenze dafür fest, wie viel Intelligenz überhaupt erzeugt werden kann.
Warum das wichtig ist: Im Vereinigten Königreich ist beim Bau eines neuen KI-Rechenzentrums oft nicht die Beschaffung der GPUs das Schwierigste, sondern der Netzanschluss, der Jahre dauern kann. Bei kleineren Installationen ist die Frage eine lokale: Kann Ihr Gebäude oder Serverraum ein Rack mit Strom versorgen und kühlen, das ein Vielfaches der Leistung eines gewöhnlichen IT-Racks aufnimmt? Auch die Energiekosten fließen direkt in den Preis jeder Antwort ein, die eine KI gibt.
3. Schicht 2: Chips
Über der Energie liegen die Chips, die Strom in Rechenleistung umwandeln. KI braucht eine bestimmte Art davon: Prozessoren, die Tausende von Berechnungen gleichzeitig ausführen (Parallelität), Speicher, der schnell genug ist, um sie mit Daten zu versorgen (High-Bandwidth Memory), und Verbindungen, die schnell genug sind, damit viele Chips wie einer arbeiten. GPUs erfüllen das, und deshalb wurden sie zum Antrieb der modernen KI.
Warum das wichtig ist: Der Fortschritt auf dieser Schicht entscheidet, wie schnell KI wachsen kann und wie günstig jede Antwort wird. Jede GPU-Generation erzeugt mehr Tokens bei gleicher Leistungsaufnahme. Die Wahl der Hardware ist eine Abwägung zwischen Speicher (der bestimmt, wie groß das Modell sein kann, das Sie betreiben), Geschwindigkeit, Leistungsaufnahme und Verfügbarkeit. Ein Desktop-System mit 128 GB wie DGX Spark, ein RTX PRO 6000 Server mit 96 GB und ein Rack mit den neuesten Rechenzentrums-GPUs eignen sich jeweils für ganz unterschiedliche Aufgaben.
4. Schicht 3: Infrastruktur, die KI-Fabrik
Chips allein ergeben noch keine KI. Sie brauchen Grundstücke, Gebäude, Stromversorgung, Kühlung, Netzwerke und die Software, die Zehntausende von Prozessoren wie eine einzige Maschine arbeiten lässt. Huang nennt diese Anlagen KI-Fabriken: Sie sind nicht dafür gebaut, Informationen zu speichern, sondern Intelligenz herzustellen.
Warum das wichtig ist: Hier entscheidet sich in der Praxis, ob die meisten Projekte gelingen oder scheitern. Die Fragen sind physischer und betrieblicher Natur: Rack-Leistung und Flüssigkeitskühlung, das Netzwerk zwischen den Servern, Speicher, der schnell genug für Trainingsdaten ist, Scheduling, Monitoring, Sicherheit und die Frage, wer das alles betreibt. Sie können diese Schicht besitzen, leasen oder bei einer Cloud mieten. Die richtige Antwort hängt davon ab, wie stark die Hardware ausgelastet sein wird und wo Ihre Daten bleiben müssen.
5. Schicht 4: Modelle
Über der Infrastruktur liegen die Modelle, der Teil, den die meisten Menschen als „KI“ betrachten. Huang betont, dass Sprachmodelle nur eine Kategorie sind. Modelle verstehen inzwischen Biologie, Chemie, Physik, Finanzen, Medizin und die physische Welt, und einige der wichtigsten Arbeiten finden in Proteindesign, Chemie, Simulation, Robotik und autonomen Fahrsystemen statt.
Ein Modell durchläuft zwei Phasen. Beim Training lernt es aus Daten; das erfordert die meiste Rechenleistung und findet nur gelegentlich statt. Bei der Inferenz wird es genutzt, um Fragen zu beantworten oder Arbeit zu erledigen; das geschieht bei jeder Nutzung und verbraucht im großen Maßstab insgesamt mehr Rechenleistung. Huang verweist außerdem auf offene Modelle, die kostenlos heruntergeladen und betrieben werden können: Wenn ein offenes Modell zur Spitze aufschließt, wie es DeepSeek-R1 tat, steigert das die Nachfrage auf jeder Schicht darunter.
Warum das wichtig ist: Das gewählte Modell bestimmt Ihre Kosten, Ihre Hardware und Ihr Datenrisiko. Mit einem großen Frontier-Modell über eine API ist der Einstieg schnell. Ein offenes Modell auf eigener Hardware hält die Daten im Haus und kann bei hohem Volumen günstiger sein. Die meisten Organisationen nutzen am Ende beides.
6. Schicht 5: Anwendungen
Ganz oben stehen die Anwendungen, wo der wirtschaftliche Wert entsteht: Plattformen für die Wirkstoffforschung, Industrieroboter, juristische Copilots, Kundenservice-Agenten, Coding-Assistenten, selbstfahrende Autos. In Huangs Worten ist ein selbstfahrendes Auto eine KI-Anwendung, verkörpert in einer Maschine, und ein humanoider Roboter eine KI-Anwendung, verkörpert in einem Körper: derselbe Stack, unterschiedliche Ergebnisse.
Die große Veränderung, sagt er, kam im vergangenen Jahr: Die Modelle wurden gut genug, um im großen Maßstab nützlich zu sein. Das logische Schließen verbesserte sich, Fehler und „Halluzinationen“ gingen zurück, und die Antworten stützten sich stärker auf echte Quellen. KI ging vom Beantworten von Fragen zum Erledigen von Arbeit über, als Agenten, die Schritte planen und Werkzeuge nutzen.
Warum das wichtig ist: Dies ist die einzige Schicht, die Ihre Kunden sehen, und diejenige, die alles darunter bezahlen muss. Beginnen Sie mit einem geschäftlichen Problem, dessen Lösung sich lohnt, und arbeiten Sie sich dann durch den Stack nach unten zu dem, was dafür nötig ist.
7. Warum die Schichten nur zusammen funktionieren
Der Kern des Torten-Bilds ist, dass keine Schicht für sich allein steht. Jede erfolgreiche Anwendung beansprucht jede Schicht unter ihr, „bis hinunter zum Kraftwerk, das sie am Leben hält“, wie Huang es formuliert. Bessere Chips machen Antworten günstiger; günstigere Antworten machen mehr Anwendungen lohnend; mehr Anwendungen brauchen mehr Infrastruktur und mehr Energie. Jede Schicht verstärkt die anderen.
Deshalb nennt Huang dies den größten Infrastrukturausbau der Menschheitsgeschichte, und deshalb argumentiert er, dass wir noch am Anfang stehen: einige hundert Milliarden Dollar sind investiert, Infrastruktur im Wert von Billionen Dollar muss noch gebaut werden. Das ist auch der Grund, warum KI so viele Branchen gleichzeitig berührt, von der Stromerzeugung und dem Bauwesen bis zu Software und Gesundheitswesen.
8. Was das für Arbeitsplätze bedeutet
Huang macht zwei Aussagen zur Arbeit. Erstens braucht der Ausbau selbst sehr viele Fachkräfte: Elektriker, Installateure, Rohrleitungsbauer, Stahlbauer, Netzwerktechniker, Monteure und Betreiber. Man braucht keinen Doktortitel in Informatik, um daran mitzuwirken.
Zweitens übernimmt KI Aufgaben, nicht ganze Berufe. Sein Beispiel ist die Radiologie: KI hilft inzwischen beim Auswerten von Aufnahmen, und doch wächst die Nachfrage nach Radiologen weiter, denn die eigentliche Aufgabe eines Radiologen ist die Versorgung von Patienten, nicht das Auswerten von Aufnahmen. Wenn KI Routinearbeit übernimmt, versorgen Krankenhäuser mehr Patienten und stellen mehr Personal ein. In seinen Worten: Produktivität schafft Kapazität, und Kapazität schafft Wachstum.
9. Was das für Ihr Unternehmen bedeutet
Sie müssen nicht alle fünf Schichten besitzen. Aber Sie müssen wissen, von welchen Sie abhängen, und auf jeder eine bewusste Entscheidung treffen:
| Schicht | Die Frage, die Sie stellen sollten | Wie Workstation hilft |
|---|---|---|
| Anwendungen | Welches geschäftliche Problem sollten wir zuerst lösen, und wie messen wir den Erfolg? | KI-Agenten, KI-Beratung, Agentenentwicklung |
| Modelle | Frontier-API, offenes Modell oder beides? Wo müssen die Daten bleiben? | Private KI, MLOps-Einrichtung |
| Infrastruktur | Kaufen, leasen oder mieten? Wer betreibt sie? | GPU-Cluster, GPU-Leasing, KI-Rechenzentrum |
| Chips | Wie viel GPU-Speicher und Geschwindigkeit braucht die Arbeitslast? | KI-Workstations, DGX Spark und RTX PRO Server in unserem Shop |
| Energie | Kann unser Standort sie mit Strom versorgen und kühlen? Was kostet jede Antwort im Betrieb? | Strom- und Kühlungsplanung als Teil jedes Server- und Clusterprojekts |
Sprechen Sie mit uns darüber, wo Ihre Organisation in der Torte steht und was Sie als Nächstes aufbauen oder kaufen sollten.
Quellen
- Jensen Huang, „AI Is a 5-Layer Cake“, NVIDIA Blog, 10. März 2026.
- NVIDIA Blog, „Largest Infrastructure Buildout in Human History“: Jensen Huang on AI's „Five-Layer Cake“ at Davos, Januar 2026.
Jensen Huang ist am 12. November 2026 als President und CEO von NVIDIA zurückgetreten; die hier zitierten Aussagen machte er, während er das Unternehmen leitete. NVIDIA und DGX sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den USA und anderen Ländern.