NVIDIA NVKE und NVKR: Warum GPU-Kubernetes zum Betriebssystem der KI-Fabrik wird
Was NVIDIA auf der KubeCon 2026 als Open Source veröffentlicht hat, warum es wichtig ist und was es für Entwickler und DevOps-Ingenieure bedeutet
 Balinder Walia14. November 20269 min read
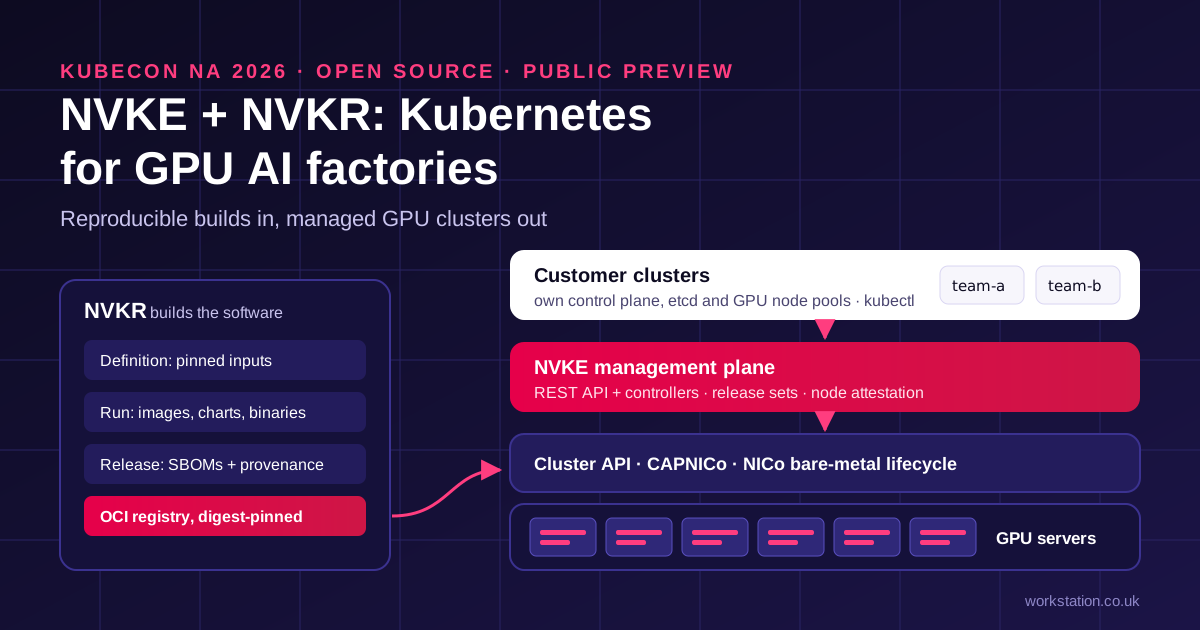
Auf der KubeCon North America am 10. November 2026 hat NVIDIA zwei Projekte als Open Source veröffentlicht: NVIDIA Kubernetes Engine (NVKE) und NVIDIA Kubernetes Recipes (NVKR). Auf den ersten Blick sind sie einfach weitere Kubernetes-Tools. Die größere Geschichte ist die Richtung, in die sie weisen: GPU-Kapazität wird zunehmend über Kubernetes genutzt, und jemand muss diese Cluster bauen, betreiben und aktualisieren. Dieser Beitrag erklärt verständlich, was die beiden Projekte leisten, warum sie wichtig sind, was sie für Entwickler und DevOps-Ingenieure bedeuten und wer sie sich jetzt ansehen sollte.

Was NVIDIA angekündigt hat
NVIDIA hat beide Projekte auf GitHub in seiner Organisation DSX AI Factory veröffentlicht, zusammen mit einer ausführlichen Anleitung im NVIDIA Technical Blog. Sie sind Komponenten der NVIDIA DSX AI Factory Platform, des Referenzdesigns von NVIDIA für den Aufbau und Betrieb von GPU-Rechenzentren.
- NVKE (NVIDIA Kubernetes Engine) ist eine Management-Plane. Sie installieren sie einmal auf einem kleinen Cluster Ihrer eigenen Server, und sie erstellt und betreibt separate Kubernetes-Cluster für Ihre Kunden. Jeder Kundencluster erhält eine eigene Control Plane, eine eigene etcd-Datenbank und eigene GPU-Node-Pools. Sie verwalten sie über eine API und ein Kommandozeilentool namens
nvkectl; Ihre Kunden nutzen ihre Cluster mit ganz normalemkubectl. - NVKR (NVIDIA Kubernetes Recipes) ist ein Build- und Release-System. Es nimmt einen deklarierten Satz von Softwareversionen, baut die Betriebssystem-Images der Knoten, Container-Images, Helm-Charts und Binärdateien und hält genau fest, was in jedes davon eingeflossen ist, mit Software Bills of Materials (SBOMs), Provenienz und Signaturen, die Sie gegen Ihre eigenen Richtlinien prüfen können.
Die beiden lassen sich gemeinsam oder getrennt einsetzen. NVKE hängt zur Laufzeit nicht von NVKR ab, und NVKR kann Artefakte für andere Kubernetes-Managementsysteme bauen. NVIDIA gibt an, dass NVKE eine Certified Kubernetes AI Platform und ein Certified Kubernetes Installer ist, konformitätsgetestet auf Kubernetes 1.36.
NVIDIA nannte auch frühe Anwender. Die NVIDIA Cloud Partners Firmus und SK Telecom integrieren NVKE und NVKR in ihre KI-Fabriken, und Mirantis, Rafay, Spectro Cloud, OpenNebula Systems und vCluster integrieren Komponenten in ihre Managed-Kubernetes-Produkte, während Netris NVKE in seiner Netzwerkautomatisierung unterstützt.
Warum das wichtiger ist als ein weiteres Kubernetes-Tool
Vor fünf Jahren bedeutete „GPU-Infrastruktur“ ein paar Server unter einem Schreibtisch und ein gemeinsames Login. Heute möchten diejenigen, die GPU-Kapazität einkaufen, ob Forschungsgruppe, Produktteam oder externer Kunde, sie zunehmend so erhalten wie alles andere: als Kubernetes-Cluster, auf den sie ihre vorhandenen Tools richten können. Das ist ein berechtigter Wunsch. Es ist aber auch ein schwer zu erbringender Dienst. Hinter „Geben Sie mir einen Cluster mit vier GPU-Knoten“ steckt eine lange Liste von Aufgaben:
- freie Server finden und sie mit dem richtigen Betriebssystem, den richtigen Treibern und Agenten booten;
- sicherstellen, dass ein Server tatsächlich einer der Ihren ist, bevor er dem Cluster irgendeines Kunden beitritt;
- den Cluster eines Kunden vom nächsten isoliert halten;
- Kubernetes und die Node-Images aktualisieren, ohne laufende Trainingsjobs zu unterbrechen;
- genau wissen, welche Softwareversionen auf jedem Knoten laufen, wenn etwas schiefgeht, und sie später identisch neu bauen;
- und all das für mehrere GPU-Generationen und mehrere Kubernetes-Versionen qualifizieren.
Große Public Clouds haben das intern gelöst, mit großen internen Teams. NVKE und NVKR sind der Versuch von NVIDIA, dieselben Bausteine allen anderen zu geben, die GPUs betreiben: spezialisierten GPU-Clouds, Telekommunikationsanbietern, souveränen KI-Fabriken, Universitäten und Unternehmen mit eigenen Racks. Das interessante Signal ist nicht, dass NVIDIA einen Kubernetes-Installer geschrieben hat. Es ist, dass das Unternehmen, das die GPUs herstellt, deren Betrieb über Kubernetes nun als Teil des Produkts betrachtet.
Wie es funktioniert, in vier Schritten

- Bauen. NVKR baut das Node-Image (ein Disk-Image mit installiertem Kubernetes, Netzwerk-Stack und Node-Agenten), das Image des NVKE-Controllers, dessen Helm-Chart und das Tool
nvkectl, alles aus versionsfixierten Quellen. - Bootstrap.
nvkectlstartet einen kleinen temporären Cluster auf einer Bootstrap-Maschine. Dieser temporäre Cluster fordert bei NVIDIA Infra Controller (NICo), dem Bare-Metal-Bereitstellungsdienst von NVIDIA, drei Server an, bootet sie vom Node-Image und übergibt an sie. Die drei Server werden zum dauerhaften Management-Cluster, und der temporäre wird gelöscht. - Veröffentlichen, was Kunden ausführen dürfen. Der Betreiber veröffentlicht „Release Sets“: eine benannte, getestete Kombination aus Maschinen-Image, Kubernetes-Version und Knotenkonfiguration. Kunden wählen ein Release nach Namen; mit Betriebssystem-Images oder Boot-Skripten haben sie nie zu tun.
- Cluster erstellen. Ein Kundencluster ist eine kurze YAML-Anfrage: Kubernetes-Version, drei Control-Plane-Server, ein GPU-Node-Pool einer bestimmten Größe. NVKE stellt ihn bereit, und der Betreiber übergibt dem Kunden eine kubeconfig.
Zwei Designentscheidungen fallen auf. Erstens muss jeder Knoten seine Identität mithilfe seines Hardware-Sicherheitschips (TPM) und des Identitäts-Frameworks SPIFFE/SPIRE nachweisen, bevor er Zugangsdaten für den Beitritt zu einem Cluster erhält. Zweitens nutzt NVKE die standardmäßige Kubernetes Cluster API für die Kommunikation mit der Infrastruktur, sodass die Bereitstellungsschicht eine gut verstandene offene Schnittstelle ist und keine Blackbox. Unsere Technote geht jeden Schritt mit den Befehlen, der Konfiguration und den fixierten Versionen durch.
Was „Public Preview“ hier wirklich bedeutet
NVIDIA ist ungewöhnlich offen, was die aktuellen Grenzen angeht, und sie sind für jeden wichtig, der einen Dienst plant:
- Nach der Installation läuft die NVKE-API über einfaches HTTP mit ausgeschalteter Authentifizierung. Sie müssen das Netzwerk einschränken, die Authentifizierung aktivieren und selbst TLS davorschalten.
- NVKE führt keine Autorisierung durch: Jeder authentifizierte Aufrufer kann den Cluster jedes beliebigen Kunden erstellen oder löschen.
- Der Management-Cluster aktualisiert, skaliert und repariert sich nicht selbst, und es gibt dafür noch kein dokumentiertes Upgrade- oder Backup-und-Restore-Verfahren.
- Kunden erhalten eine Administrator-kubeconfig, die sich erst mit Ablauf ihres Zertifikats widerrufen lässt.
- NICo ist der Standardweg (und in der Praxis der Hauptweg), um Maschinen zu erhalten.
- Noch kein NVKR-Release ist „qualifiziert“, und die Node-Images mit vollständiger Festplattenverschlüsselung sind nur zur Evaluierung gedacht.
Nichts davon überrascht bei einem ersten öffentlichen Release, und die öffentlichen Roadmaps zeigen, wohin die Reise geht. Es bedeutet aber, dass NVKE heute etwas zum Evaluieren ist, nicht etwas, auf das man ein Service Level verkauft.
Die Erkenntnis für Entwickler und DevOps-Ingenieure
Es gibt die verbreitete Vorstellung, KI-Engineering ersetze Cloud- und DevOps-Arbeit. Ankündigungen wie diese legen das Gegenteil nahe. KI stellt neue, höhere Anforderungen an genau diese Kompetenzen.
Zu wissen, wie man ein großes Sprachmodell über eine API aufruft, ist nützlich. Es ist aber auch der Teil, der am leichtesten zu lernen und am leichtesten zu automatisieren ist. Die Ingenieurstiefe liegt im Verständnis, wie KI-Systeme im Produktivbetrieb laufen, skalieren und scheitern:
- GPU-bewusstes Scheduling. Wie Kubernetes GPU-Workloads platziert, wie Node-Pools pro GPU-Generation aussehen und warum eine untätige GPU in einem „laufenden“ Job der teuerste Bug ist, den Sie je ausliefern werden.
- Unveränderliche, reproduzierbare Infrastruktur. Die gesamte Prämisse von NVKR ist, dass Sie genau angeben können sollten, was auf einem Knoten ist, und ihn Byte für Byte neu bauen können. Das ist DevOps und Lieferkettensicherheit, angewandt auf GPU-Flotten.
- Identität und Isolation. Hardware-Attestierung, etcd-Verschlüsselung pro Cluster, Netzwerkisolation zwischen Mandanten und ein sorgfältiger Umgang mit Zugangsdaten sind Kompetenzen der Plattformsicherheit, nicht der Data Science.
- Lebenszyklus und Upgrades. Eine neue Kubernetes-Version oder einen neuen Treiber über GPU-Knoten auszurollen, ohne einen wochenlangen Trainingslauf abzubrechen, ist ein Planungs- und Automatisierungsproblem.
- Observability. NVKE liefert eine auf OpenTelemetry basierende Telemetrie-Pipeline mit. Jemand muss trotzdem entscheiden, was gemessen wird, wohin es geht und was einen Menschen weckt.
Wenn Sie als Entwickler in die KI wechseln, macht Sie das Wissen darüber, wie diese Cluster gebaut und betrieben werden, weitaus nützlicher als ein weiterer Prompt-Engineering-Kurs. Wenn Sie bereits Plattform- oder DevOps-Ingenieur sind, werden Ihre Kompetenzen nicht überflüssig; sie werden bald auf einer neuen und deutlich teureren Hardwareklasse gefragt sein.
Werden GPU-orientierte Kubernetes-Plattformen ein wesentlicher Teil von Enterprise-KI?
Unsere Einschätzung: ja, aber nicht so, wie die Schlagzeilen es vermuten lassen. Die meisten Unternehmen werden NVKE nicht selbst installieren. Wahrscheinlich ist, dass die Anbieter, bei denen sie GPU-Kapazität einkaufen, also spezialisierte GPU-Clouds, Telekommunikationsanbieter, souveräne KI-Programme und Managed Service Provider, sich auf etwas Vergleichbares standardisieren, weil es die Kosten senkt, „Kubernetes mit GPUs“ als Dienst anzubieten. Unternehmen werden die Wirkung in Form konsistenterer, portablerer GPU-Cluster spüren, wo auch immer sie diese mieten oder betreiben.
Für Organisationen, die eigene GPU-Racks betreiben, ist das Argument am stärksten, wenn mehrere Teams oder Kunden aus einem gemeinsamen Hardwarepool bedient werden. Ein einzelnes Team auf einem einzelnen Cluster ist heute meist mit einer ausgereiften, unterstützten Kubernetes-Distribution besser bedient und übernimmt dabei die Disziplin von NVKR mit versionsfixierten, signierten, reproduzierbaren Node-Images.

Wer sich NVKE und NVKR jetzt ansehen sollte
| Sie sind | Was jetzt zu tun ist |
|---|---|
| Eine GPU-Cloud, ein Hosting-Anbieter oder ein Telekommunikationsanbieter, der Kunden Kubernetes anbietet | Evaluieren Sie NVKE ernsthaft. Führen Sie den lokalen Quickstart aus, dann ein Labor auf freier Hardware mit NICo, und ordnen Sie jede Einschränkung der Preview Ihren Servicezusagen zu. |
| Ein Unternehmen oder eine Universität, die einen GPU-Pool zwischen Abteilungen teilt | Führen Sie den lokalen Quickstart aus und verfolgen Sie die Roadmap. Beginnen Sie jetzt mit versionsfixierten, signierten Node-Images, unabhängig davon, welchen Installer Sie verwenden. |
| Ein einzelnes Team mit einem GPU-Cluster | Behalten Sie Ihre aktuelle Distribution. Übernehmen Sie die Ideen von NVKR zu reproduzierbaren Builds und SBOMs. |
| Noch ohne GPU-Betrieb | Lernen Sie das Betriebsmodell zuerst auf einem geleasten oder verwalteten GPU-Cluster; die Kompetenzen lassen sich direkt übertragen. |
Der lokale Quickstart benötigt lediglich einen Linux-Host oder eine virtuelle Maschine mit mindestens 6 CPUs, 12 GiB freiem Arbeitsspeicher und 100 GiB freiem Festplattenplatz sowie Docker und Unterstützung für virtuelles TPM. Weder eine GPU noch ein NVIDIA-Konto sind erforderlich, es gibt für ein Plattformteam also kaum einen Grund, es nicht auszuprobieren.
Was Workstation tut
Wir planen, liefern und betreiben GPU-Infrastruktur für Organisationen in Großbritannien, und Kubernetes ist der Weg, über den die meisten unserer Kunden sie nutzen.
- Private GPU-Clouds. Wir planen und bauen GPU Private Clouds von Grund auf: Server, Netzwerk, Storage und die Kubernetes-Schicht darüber, dimensioniert mit unseren VRAM- und Readiness-Tools.
- Kubernetes-Plattformen für KI. Wir richten GPU-fähiges Kubernetes, GitOps-Delivery und MLOps-Pipelines ein (siehe unsere Beiträge zum Betrieb eigener LLMs auf Kubernetes und zu Kubeflow und Argo CD), und wir helfen Ihnen, eine Evaluierung von NVKE und NVKR auf Ihrer eigenen Hardware zu planen.
- Leasen statt kaufen. Wenn das Kapital der Engpass ist, vergleicht gpuleasing.co.uk Leasing und Kauf von GPU-Servern für Ihre Workload.
Nächste Schritte
- Lesen Sie die Technote zu NVKE und NVKR für den vollständigen Ablauf, die Konfiguration, die fixierten Versionen und eine Härtungs-Checkliste für die Preview.
- Probieren Sie den lokalen Quickstart im NVKE-Repository aus und sehen Sie sich das NVKR-Repository an.
- Fragen Sie unseren KI-Vertriebsingenieur, um einen GPU-Cluster für Ihre Workloads zu dimensionieren, oder sprechen Sie mit uns über eine Kubernetes-Plattform für Ihre GPUs.
Die Fakten zu NVKE und NVKR stammen aus der Ankündigung von NVIDIA und der öffentlichen Dokumentation der Projekte mit Stand 14. November 2026. Beide befinden sich in der Public Preview, und ihre APIs und ihr Verhalten können sich zwischen Releases ändern.
Hinweis zu Schutzrechten: NVIDIA, das NVIDIA-Logo und DSX sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den Vereinigten Staaten und anderen Ländern. Kubernetes ist eine eingetragene Marke der Linux Foundation. Andere genannte Produkt- und Firmennamen sind Eigentum ihrer jeweiligen Inhaber. Alle diese Rechte werden anerkannt und bleiben ihren Inhabern vorbehalten.