Der Shop ist online

Wir bauen Workstation AI-Maschinen für Websites, KI-Agenten und LLM-Training – online konfigurieren und kaufen.

Händlerpreise erhalten
KI-Produkte
KI-LabsOpenAI-AgentenClaude-AgentenGrok-BotWorkstation AI-natives CRMMarketingAlle Produkte
KI-Lösungen
Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI-WorkstationsNVIDIA-Hardware & -SoftwareNVIDIA Accelerated ComputingPrivate KIGPU-Private-CloudGPU-ClusterEdge-KIKI nach Branche
KI-Services
PlattformmodernisierungDigital EngineeringDatengrundlagen & KIAutonomer BetriebKI-BeratungDevOps-AutomatisierungCybersicherheitSoftwareentwicklungAgentenentwicklungMLOps-EinrichtungGPU-LeasingGPU-Private-Cloud
Über uns
UnternehmenUnsere GeschichtePartnerKundengeschichten
KI-Rechenzentren
KI-RechenzentrenGPU-Private-CloudGPU-ClusterGPU-Leasing
KI-EinblickeJev-ReiheBenchmark LabModellauswahl
Technische Hinweise
Dokumentation
Linux-BetriebssystemeUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
KI-Cloud-PlattformenAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-Clouds & Marktplätze
Private KI-RechenzentrenFür AnwaltskanzleienFür Steuer- und WirtschaftsprüfungskanzleienOn-Premises-PlattformenVollständig abgesicherte Cloud
ToolsRing PromoterJobshout
News
Blog
KontaktAnmelden

KI-Workstations, Multi-Agenten-KI-Software, GPU-Infrastruktur und intelligente Agentenlösungen für moderne Unternehmen.

Kontakt

KI-Lösungen

Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI nach Branche

Produkte

Alle ProdukteWorkstation AI-natives CRM & ERPMarketingOpenAI-AgentenRing PromoterJobshout

Unternehmen

Über unsUnternehmenKI-RechenzentrenWarum WorkstationPartnerKundengeschichtenPreiseKontaktTenthMatrix

Ressourcen

KI-EinblickeTechnische HinweiseDokumentationLinux-BetriebssystemeKI-Cloud-PlattformenPrivate KI-RechenzentrenBlogSucheSitemap
Büro Belgien
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Mo – Fr: 9:00 – 18:00 Uhr MEZ
+32 492 45 67 46
Hauptsitz Großbritannien
77-79 Marlowes, Hemel Hempstead HP1 1LFAnfahrt – Ausfahrt 20 der M25 (Outer London)Handelsregisternr.: 11641870Mo – Fr: 9:00 – 18:00 Uhr GMT
+44 7515 356 146
Büro Indien
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Büro Taiwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Mo – Fr: 9:00 – 18:00 Uhr Taiwan-Zeit (GMT+8)
+886 926 892 701+32 492 45 67 46
Büro Estland
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaMo - Fr: 9:00 - 18:00 Uhr estnischer Zeit (EET)
+32 492 45 67 46

© 2026 Workstation AI. Alle Rechte vorbehalten.

DatenschutzDatenlöschungCookiesNutzungsbedingungenWebsite-Sitemap

NVIDIA, das NVIDIA-Logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX und HGX sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den USA und anderen Ländern. AMD, das AMD-Arrow-Logo, EPYC, Instinct, Ryzen und Threadripper sind Marken von Advanced Micro Devices, Inc. Dell und PowerEdge sind Marken der Dell Inc. oder ihrer Tochtergesellschaften. Intel und Xeon sind Marken der Intel Corporation oder ihrer Tochtergesellschaften. AMAX, AceleMax und LiquidMax sind Marken der AMAX Engineering Corporation. Alle anderen Produktnamen, Logos und Marken sind Eigentum ihrer jeweiligen Inhaber. Wir verwenden sie ausschließlich, um die Produkte zu kennzeichnen, die wir beschreiben, liefern oder unterstützen; ihre Verwendung bedeutet nicht, dass ihre Inhaber uns empfehlen.

Loading blogs...

Der Workstation-Blog

GPU

Beiträge mit dem Tag GPU.
Allaidevopskubernetesllmai-agentssecuritysreengineering
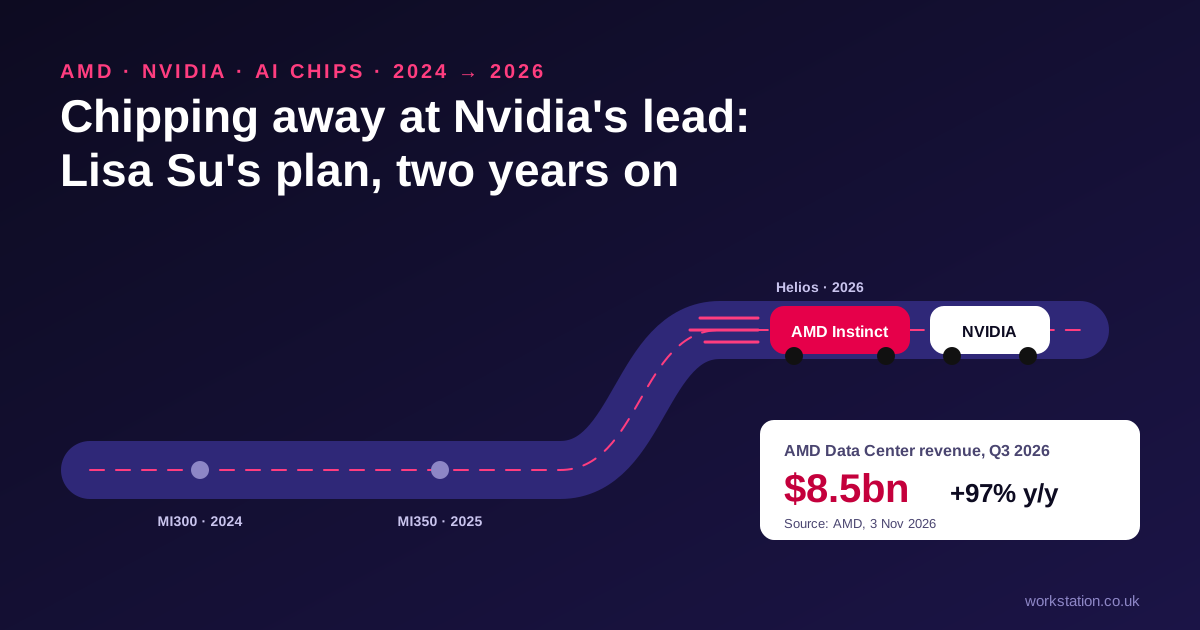
Chipping Away at Nvidia's Lead: Lisa Su's AMD Plan, Two Years On
2026-11-14 17:13:54.400049

Chipping Away at Nvidia's Lead: Lisa Su's AMD Plan, Two Years On

In December 2024 Bloomberg's The Circuit asked AMD CEO Lisa Su how she would chip away at Nvidia's lead in AI. We check the plan against AMD's 2026 results and Helios launch, and explain what a credible second AI platform means for UK buyers. Includes a link to the interview.
WorkstationLesen
NVIDIA NVKE und NVKR: Warum GPU-Kubernetes zum Betriebssystem der KI-Fabrik wird
2026-11-14

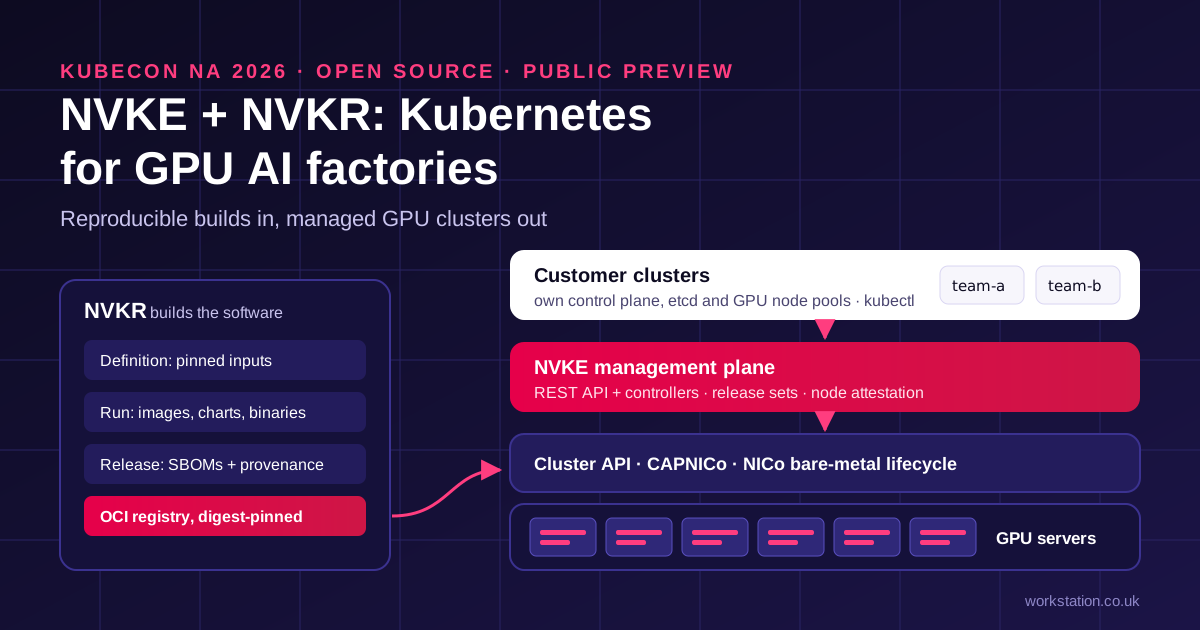
NVIDIA NVKE und NVKR: Warum GPU-Kubernetes zum Betriebssystem der KI-Fabrik wird

NVIDIA hat NVIDIA Kubernetes Engine (NVKE) und NVIDIA Kubernetes Recipes (NVKR) als Open Source veröffentlicht, um Managed Kubernetes auf GPU-Infrastruktur zu betreiben. Was sie einfach erklärt leisten, was Public Preview wirklich bedeutet, warum KI-Engineering neue Nachfrage nach Cloud- und DevOps-Kompetenzen schafft und wer sie jetzt evaluieren sollte.

Balinder WaliaLesen
NVIDIA RTX PRO 6000 Blackwell Server Edition: Eine GPU für KI, Grafik und Simulation im britischen Serverraum
2026-11-10

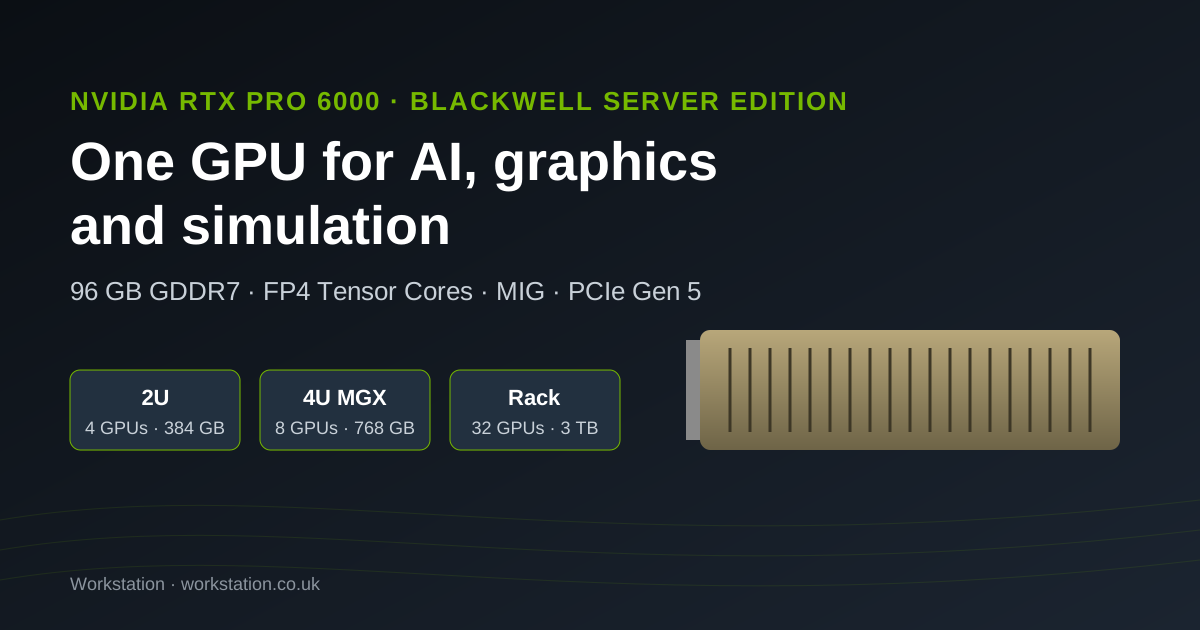
NVIDIA RTX PRO 6000 Blackwell Server Edition: Eine GPU für KI, Grafik und Simulation im britischen Serverraum

96 GB GDDR7, FP4-Tensor-Cores und RT-Cores auf einer Standard-PCIe-Karte: was NVIDIAs RTX PRO 6000 Blackwell Server Edition leistet, warum sie zu Unternehmen passt, die private KI in bereits vorhandenen Räumen betreiben, die drei Systemgrößen vom 2U-Server mit vier GPUs bis zum Rack mit 32 GPUs wie AMAX' RackScale 32 und was Sie vor der Bestellung prüfen sollten.

Balinder WaliaLesen
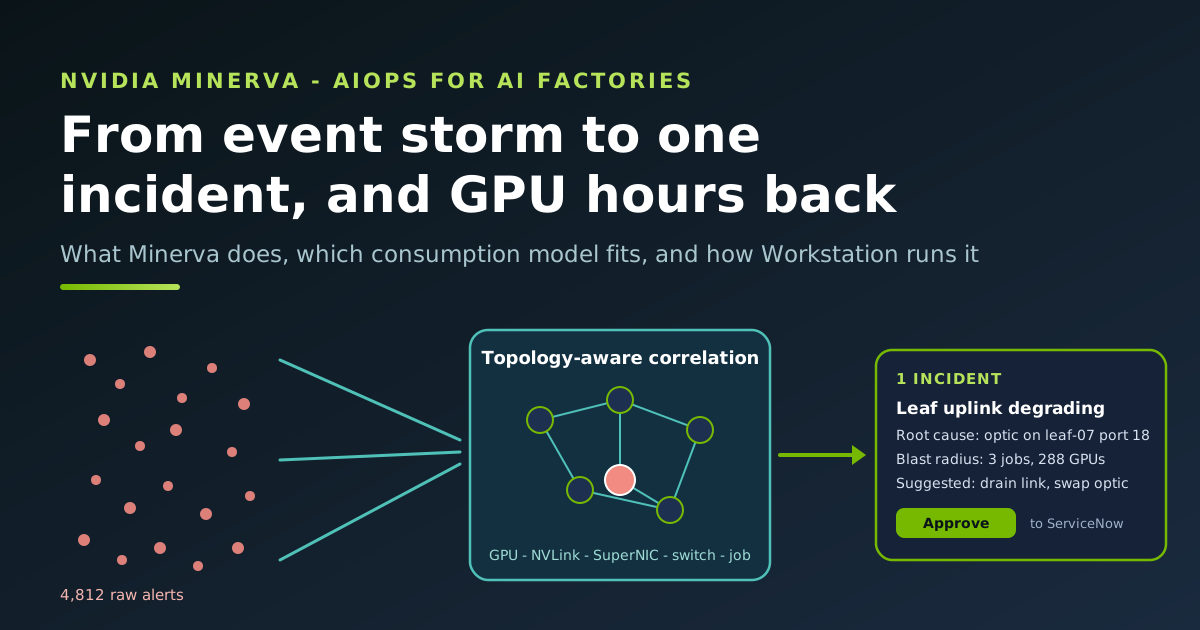
NVIDIA Minerva für KI-Fabriken: Aus Alarmstürmen werden zurückgewonnene GPU-Stunden
2026-11-09

NVIDIA Minerva für KI-Fabriken: Aus Alarmstürmen werden zurückgewonnene GPU-Stunden

Eine einzige nachlassende Optik kann Tausende von Alarmen auslösen und tausend GPUs ausbremsen. Was NVIDIA Minerva leistet, was es in GPU-Stunden, Goodput, MTBI, MTTR und Tokens wert ist, welches seiner drei Nutzungsmodelle passt, durchgerechnete Beispiele für eine Neocloud mit Vera Rubin NVL72, einen Blackwell-Cluster an einer Universität und ein Unternehmen mit Grafana und ServiceNow sowie das Verhältnis zu UFM.

Balinder WaliaLesen
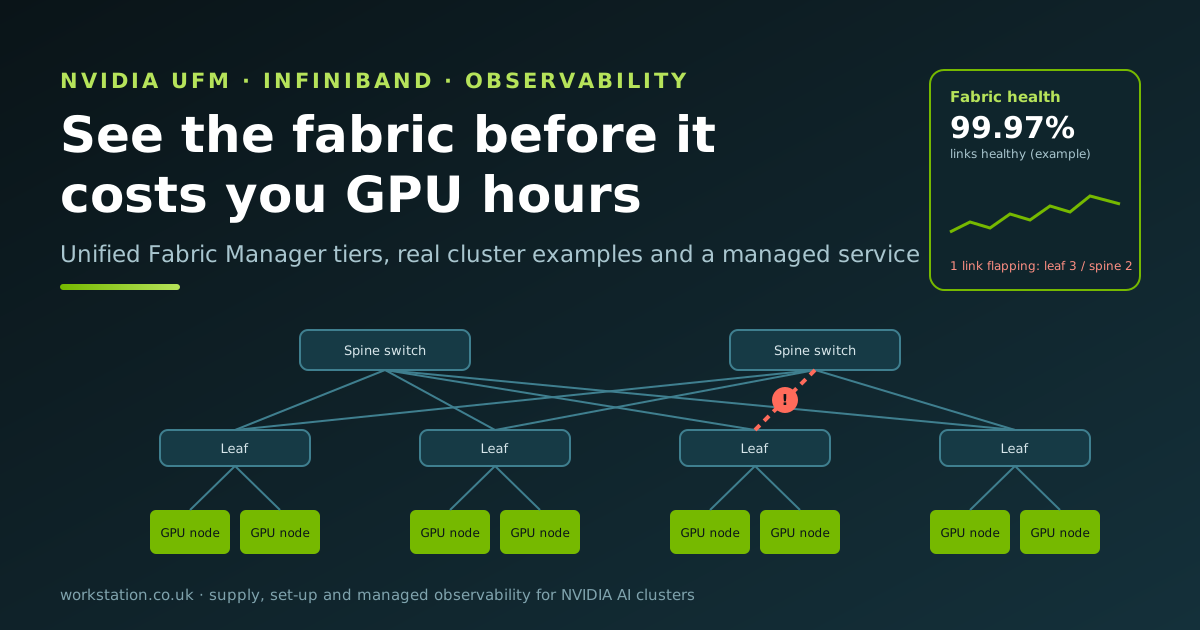
NVIDIA UFM für KI-Cluster: Warum die Sichtbarkeit des InfiniBand-Fabrics bestimmt, was Ihre GPUs wert sind
2026-11-09

NVIDIA UFM für KI-Cluster: Warum die Sichtbarkeit des InfiniBand-Fabrics bestimmt, was Ihre GPUs wert sind

Ein einziger flatternder InfiniBand-Link kann einen Job mit 256 GPUs ausbremsen. Was NVIDIA Unified Fabric Manager leistet, wann UFM Telemetry, Enterprise oder Cyber-AI passt, durchgerechnete Beispiele für einen DGX-B300-Cluster mit 4 Knoten, einen Cluster im SuperPOD-Stil mit 32 Knoten und einen Slurm-Dienst an einer Universität sowie was Fabric-Sichtbarkeit in GPU-Stunden wert ist.

Balinder WaliaLesen
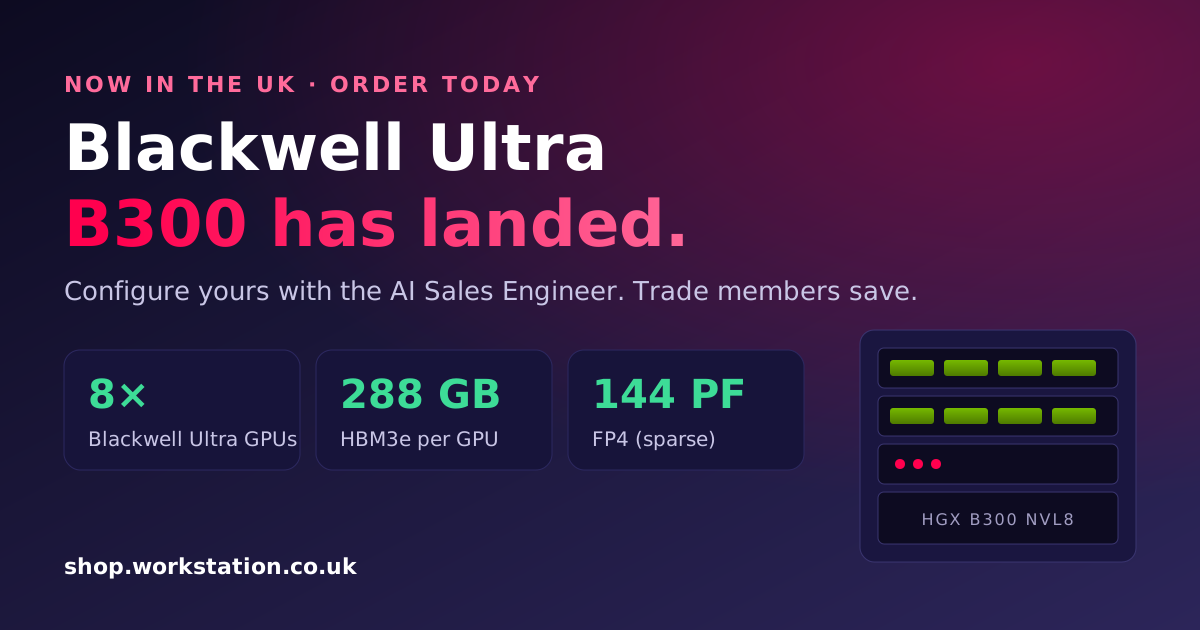
NVIDIA Blackwell Ultra B300 ist in Großbritannien angekommen: Konfigurieren Sie Ihr System noch heute
2026-11-07

NVIDIA Blackwell Ultra B300 ist in Großbritannien angekommen: Konfigurieren Sie Ihr System noch heute

NVIDIA-Blackwell-Ultra-B300-Systeme sind bei unseren britischen Distributionspartnern eingetroffen. Konfigurieren und kalkulieren Sie Ihr B300-System mit acht GPUs in wenigen Minuten mit unserem KI-Vertriebsingenieur, sparen Sie mit Workstation Trade und bestellen Sie noch heute, um bei der Auslieferung in Großbritannien ganz vorne in der Reihe zu stehen.

Balinder WaliaLesen
Private KI für Anwaltskanzleien: Eine Offline-first-Workstation wählen, der Ihre Mandanten vertrauen können
2026-11-06

Private KI für Anwaltskanzleien: Eine Offline-first-Workstation wählen, der Ihre Mandanten vertrauen können

Wie eine Anwaltskanzlei eine Workstation für private KI auswählt, die ohne Internetverbindung läuft: wer sie nutzt, welches Modell, wie viel GPU-Speicher, wie stark sie isoliert sein muss und wer sie einrichtet. Mit echten Preisen aus einem echten Angebot, den Stellen, an denen es überdimensioniert war, und den Starter-, Workforce- und Enterprise-Konfigurationen, die wir tatsächlich ausliefern würden.

Balinder WaliaLesen
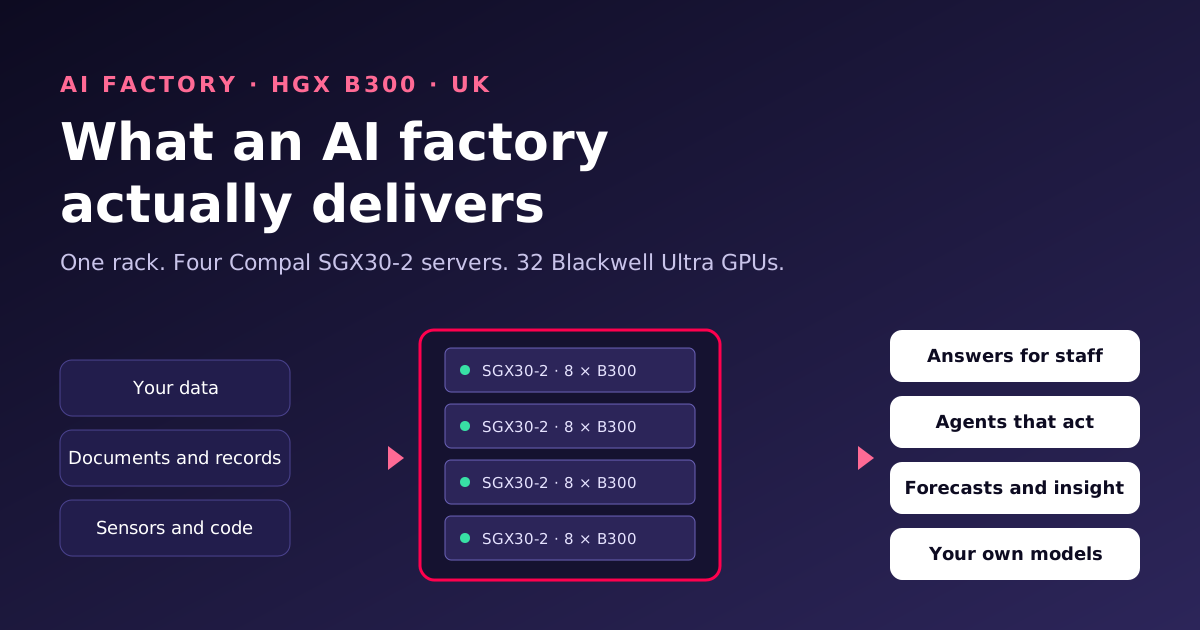
Was eine KI-Fabrik tatsächlich liefert: Ein Rack, 32 Blackwell Ultra GPUs und die Arbeit, die sie für Sie erledigt
2026-11-02

Was eine KI-Fabrik tatsächlich liefert: Ein Rack, 32 Blackwell Ultra GPUs und die Arbeit, die sie für Sie erledigt

Eine KI-Fabrik verwandelt Ihre eigenen Daten auf Hardware unter Ihrer Kontrolle in Antworten, Agenten, Prognosen und trainierte Modelle. Hier erfahren Sie, was hineingeht, was herauskommt, wie die Arbeit täglich abläuft und was ein Rack mit vier Compal SGX30-2 Servern und 32 NVIDIA Blackwell Ultra GPUs für den Betrieb benötigt.

Balinder WaliaLesen
Turbocharging LLMs
2026-08-30

Turbocharging LLMs

Workstation on turbocharging LLMs: PagedAttention paging for KV cache, vLLM serving, Self-Debugging for agents, PowerInfer token rates, and EG-MLA memory cuts — with production trade-offs.

Balinder WaliaLesen
Large Language Models Explained: How LLMs Work and How to Run Your Own on Kubernetes
2026-06-05

Large Language Models Explained: How LLMs Work and How to Run Your Own on Kubernetes

What are Large Language Models and how do they work? A clear, non-technical explainer for managers and engineers — tokens, embeddings, transformers, training and inference — plus production Kubernetes YAML to deploy your own LLM with Ollama and vLLM.

Balinder WaliaLesen

Beliebte Themen

ai99devops82kubernetes46llm41ai-agents35security30sre25engineering24

Neueste Beiträge

  1. 01Chipping Away at Nvidia's Lead: Lisa Su's AMD Plan, Two Years On2026-11-14
  2. 02NVIDIA NVKE und NVKR: Warum GPU-Kubernetes zum Betriebssystem der KI-Fabrik wird2026-11-14
  3. 03NVIDIA RTX PRO 6000 Blackwell Server Edition: Eine GPU für KI, Grafik und Simulation im britischen Serverraum2026-11-10
  4. 04NVIDIA Minerva für KI-Fabriken: Aus Alarmstürmen werden zurückgewonnene GPU-Stunden2026-11-09
  5. 05NVIDIA UFM für KI-Cluster: Warum die Sichtbarkeit des InfiniBand-Fabrics bestimmt, was Ihre GPUs wert sind2026-11-09

KI in die Produktion bringen

Von diesen Leitfäden zur laufenden Plattform – Automatisierung, Agenten und Infrastruktur, für Sie umgesetzt.

Sprechen Sie mit uns