 Workstation team
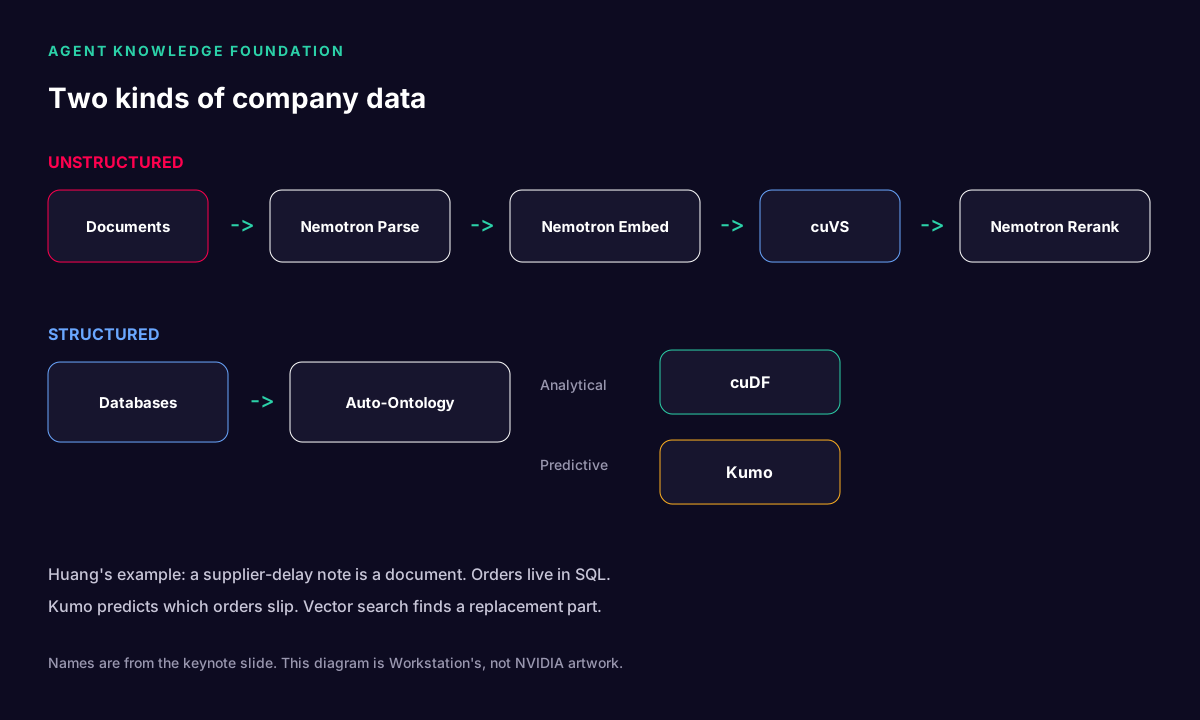
Die Folie zur Agent Knowledge Foundation auf der GTC Berlin teilt Unternehmensdaten in zwei Bereiche. Dokumente durchlaufen Nemotron Parse, Nemotron Embed, cuVS und Nemotron Rerank. Datenbanken durchlaufen Auto-Ontology, danach cuDF für die Analyse und Kumo für die Vorhersage. Dieser Beitrag erklärt jedes Kästchen, nennt die Open-Source-Frameworks, die dieselben Aufgaben erledigen, und spielt das Muster in zwei Bereichen durch, in denen beide Arten von Daten täglich aufeinandertreffen: im Gesundheitswesen und in der wissenschaftlichen Forschung. Dazu gehören auch die Chat-Assistenten und Roboter, die dort bereits im Einsatz sind.
Was Huang sagte
Ein Lieferverzug trifft als Dokument ein. Die Aufträge, die dieser Lieferant beliefert, liegen in SQL. Huang sagte, man nutze Kumo, um vorherzusagen, welche Aufträge sich verzögern, und Vektorsuche, um in den Konstruktionsunterlagen ein Ersatzteil zu finden. Das Keynote-Transkript verstümmelt Kumo zu „QMO“ und „CUMA“. Auf der Folie steht Kumo. Wir folgen der Folie.
Er sagte außerdem, Nemotron werde mit Gewichten, Daten und den Skripten zum Nachbau ausgeliefert und sei nicht automatisch ein Frontier-Sprachmodell, solange niemand es nachtrainiert. Eines der Partnerbeispiele, die er von der Bühne aus nannte, stammte aus dem Gesundheitswesen: Palantir in Zusammenarbeit mit dem Tampa General Hospital. Die vollständige Liste, so wie er sie vortrug, steht im ausführlichen Artikel. Es sind seine Beispiele, nicht unsere, und wir haben die Projekte nicht überprüft.
Die Dokumentenspur, Kästchen für Kästchen
Das ist Retrieval-Augmented Generation (RAG), dargestellt als vier getrennte Aufgaben statt als ein Kästchen. Die Aufteilung ist wichtig, weil jeder Schritt auf seine eigene Weise scheitert und einen eigenen Test braucht.
- Parsen. Ein PDF, einen Scan oder einen Foliensatz in sauberen Text, Tabellen und Bildunterschriften umwandeln, wobei Seite und Position erhalten bleiben. Arztbriefe und Laborberichte sind voller Tabellen, Kopfzeilen und Handschrift. Ein Parser, der eine Ergebnistabelle zu einer Zahlenkolonne plattdrückt, vergiftet alles Nachgelagerte. Nemotron Parse ist das Modell von NVIDIA dafür. Offene Alternativen sind Docling (von IBM), Unstructured und Marker. Zu den Cloud-Diensten gehören Azure Document Intelligence und AWS Textract.
- Einbetten. Jede Textpassage und jede Frage in einen Vektor umwandeln, sodass „Kurzatmigkeit“ und „Dyspnoe“ nahe beieinander landen. Nemotron Embed erledigt das. Weit verbreitete offene Modelle sind BGE-M3, E5 und Nomic Embed. Testen Sie jedes Embedding-Modell mit Ihrem eigenen Vokabular, bevor Sie ihm vertrauen, denn allgemeine Modelle kommen mit Arzneimittelnamen und Gensymbolen oft schlecht zurecht.
- Suchen. Die nächstgelegenen Vektoren schnell über Millionen von Passagen hinweg finden. cuVS ist die GPU-Bibliothek von NVIDIA dafür, und ihr CAGRA-Graphindex wird auch in Milvus und FAISS verwendet. Für kleinere Sammlungen reicht oft pgvector in einer bestehenden PostgreSQL-Datenbank. Qdrant und Weaviate sind weitere gängige Optionen. Kombinieren Sie Vektorsuche mit einfacher Stichwortsuche (BM25), denn Kennungen wie NHS-Nummern, Chargencodes und Gennamen erfordern exakte Treffer.
- Neu ranken. Die Suche liefert fünfzig plausible Passagen. Ein Reranker liest jede davon im Hinblick auf die Frage und setzt die fünf, die sie tatsächlich beantworten, an die Spitze. Nemotron Rerank erledigt das. Offene Alternativen sind die BGE-Reranker und Late-Interaction-Modelle im Stil von ColBERT. Nach unserer Erfahrung ist Reranking der günstigste Genauigkeitsgewinn in der gesamten Pipeline.
Das Ergebnis dieser Spur sollten immer Passagen mit ihren Quellen sein, keine fertige Antwort. Der Agent schreibt die Antwort. Die Quellenangabe ermöglicht es einem Menschen, sie zu überprüfen.
Die Tabellenspur, Kästchen für Kästchen
- Auto-Ontology. Bevor ein Modell über eine Datenbank schlussfolgern kann, muss etwas festlegen, was die Spalten bedeuten und wie die Tabellen verknüpft sind. „obs_cd 8867-4“ bedeutet für einen Agenten nichts, bis er weiß, dass es sich um einen LOINC-Code für die Herzfrequenz handelt. Huangs Folie setzt hier einen automatischen Schritt ein. Im Gesundheitswesen existiert der Großteil der Ontologie bereits: SNOMED CT für klinische Begriffe (in der gesamten NHS-Primärversorgung verwendet), LOINC für Beobachtungen, dm+d für britische Arzneimittel, ICD-10 und OPCS-4 für Diagnosen und Prozeduren. In der Wissenschaft gibt es ChEBI für Chemikalien, die Gene Ontology und UniProt. Bilden Sie auf diese ab, statt eigene zu erfinden. Die semantische Schicht von dbt und Wissensgraph-Tools wie Neo4j sind gängige Wege, die Zuordnung festzuhalten.
- Analytisch: cuDF. cuDF ist die GPU-Dataframe-Bibliothek aus dem RAPIDS-Projekt von NVIDIA. Ihr Modus
cudf.pandasbeschleunigt bestehenden pandas-Code, ohne ihn umzuschreiben, und Polars kann cuDF als GPU-Engine verwenden. Das ist die Seite „wie viele, wie viel, verglichen mit dem Vormonat“. Für die meisten Fragen ist SQL das ehrliche erste Werkzeug. Ein Sprachmodell, das SQL gegen ein gut beschriebenes Schema schreibt (Text-to-SQL) und die Abfrage anzeigt, lässt sich weitaus leichter prüfen als eines, das Zahlen rät. - Prädiktiv: Kumo. Kumo erstellt Vorhersagen direkt über viele verknüpfte Tabellen mithilfe von Graph Neural Networks, statt dass ein Data Scientist Features von Hand baut. Das Unternehmen hat ein vortrainiertes relationales Foundation Model veröffentlicht, KumoRFM. Der akademische Benchmark für diese Art von Arbeit ist RelBench aus Stanford. Die konventionelle Alternative sind nach wie vor Gradient-Boosted Trees wie XGBoost über manuell erstellte Features. Verwenden Sie das, was Sie validieren können, und validieren Sie mit Daten aus einem Zeitraum, den das Modell nie gesehen hat.
Die Frameworks, die alles zusammenhalten
Die beiden Spuren sind Bibliotheken. Etwas muss entscheiden, wann sie aufgerufen werden, den Zustand halten und Grenzen durchsetzen. Das ist der Agent-Harness, und die Berliner Keynote hat ihn zuerst in eine Sandbox gesetzt (siehe unseren Beitrag zu OpenShell).
| Aufgabe | NVIDIA-Stack | Gängige Open-Source- oder Anbieteroptionen |
|---|---|---|
| Dokumente parsen | Nemotron Parse, NeMo Retriever Extraction | Docling, Unstructured, Marker, LlamaParse |
| Einbetten und neu ranken | Nemotron Embed, Nemotron Rerank | BGE-M3, E5, Nomic Embed, BGE-Reranker, ColBERT |
| Vektorsuche | cuVS (CAGRA) | Milvus, FAISS, pgvector, Qdrant, Weaviate |
| Tabellen analysieren | cuDF, RAPIDS | SQL, DuckDB, Polars, pandas, dbt |
| Über Tabellen vorhersagen | Kumo (Partner) | XGBoost, LightGBM, PyTorch Geometric |
| Wissensgraph | Auto-Ontology-Schritt | Neo4j, Microsoft GraphRAG, RDF- und OWL-Tools |
| Agenten-Orchestrierung | NeMo Agent Toolkit, AI-Q Blueprint | LangGraph, LlamaIndex, Haystack, CrewAI, Microsoft Agent Framework (AutoGen), DSPy |
| Tool-Anbindungen | NIM-Microservices | Model Context Protocol (MCP), Agent2Agent (A2A) |
| Sprachmodell | Nemotron | Llama, Qwen, Mistral, Gemma und MedGemma oder ein gehostetes Frontier-Modell |
| Roboter | Isaac Sim, Isaac Lab, Cosmos, GR00T, Holoscan | ROS 2, MoveIt, Hugging Face LeRobot, openpi |
Keines davon ist zwingend. Ein kleines Team kann mit Docling, pgvector, einem Reranker, PostgreSQL und LangGraph oder LlamaIndex auf einer einzigen GPU-Workstation eine solide erste Version bauen. Die NVIDIA-Komponenten lohnen sich, wenn der Korpus zig Millionen Passagen oder die Tabellen Milliarden von Zeilen erreichen.
Gesundheitswesen: Warum beide Spuren nötig sind
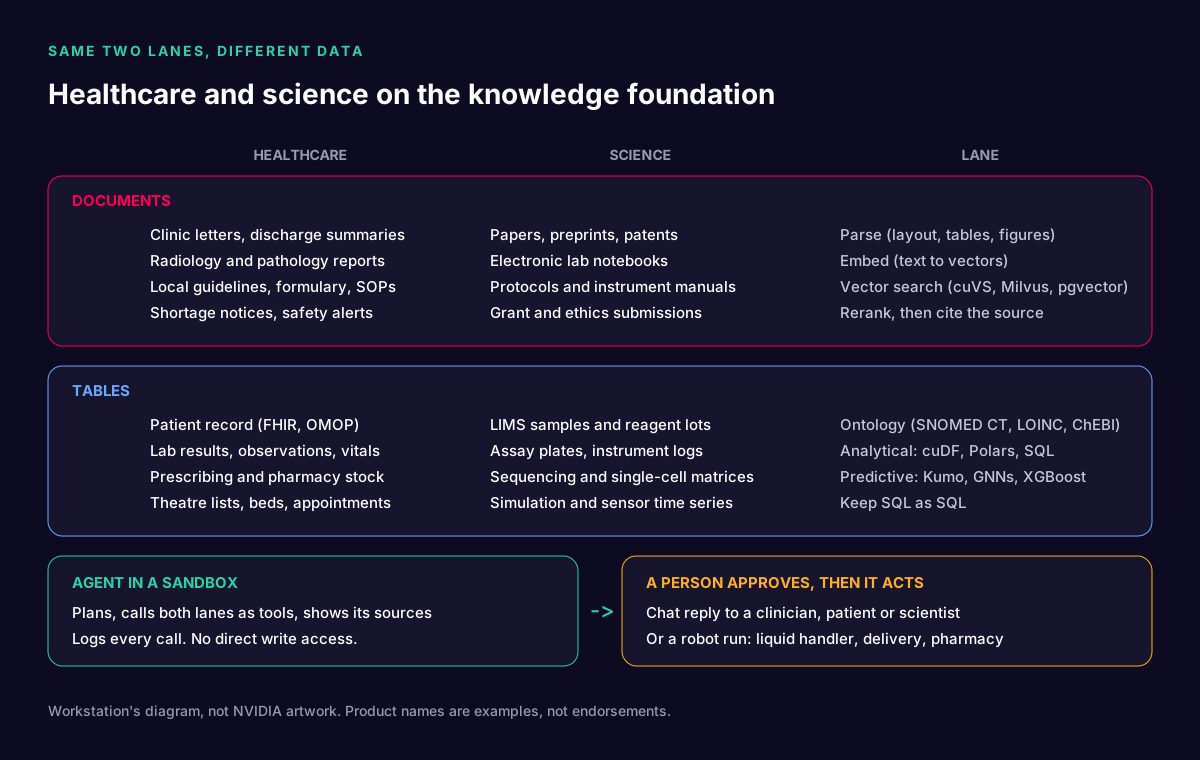
Ein Krankenhaus ist das deutlichste Beispiel für Huangs Aufteilung. Das meiste, was Klinikerinnen und Kliniker über einen Patienten wissen, ist schriftlich festgehalten: Überweisungsschreiben, Ambulanznotizen, Entlassberichte, Radiologie- und Pathologiebefunde. Was gezählt wird, etwa Ergebnisse, Verordnungen, Bettenbelegung und Termine, liegt in der elektronischen Patientenakte und ihrem Data Warehouse. Klinische Fragen erfordern fast immer beides.
Huangs Lieferantenbeispiel, übertragen
Ersetzen Sie den verspäteten Lieferanten durch einen Arzneimittelengpass.
- Eine Engpassmeldung oder ein Serious Shortage Protocol trifft als PDF oder E-Mail ein. Die Dokumentenspur parst sie und extrahiert Produkt, Wirkstärken und Daten.
- Die Tabellenspur ordnet das Produkt den dm+d-Codes zu und fragt die Verordnungsdaten ab: Welche Patienten erhalten es, wie viel Bestand hat jede Apotheke und wann ist die nächste Versorgung jedes Patienten fällig.
- Ein Vorhersagemodell ordnet anhand der Abgabehistorie und der Ambulanzpläne, welchen Patienten das Medikament zuerst ausgeht.
- Die Vektorsuche über die lokale Arzneimittelliste, Leitlinien und die Engpassmeldung findet die zugelassenen Alternativen, mit Quellenangaben.
- Der Agent entwirft eine Arbeitsliste für eine Apothekerin oder einen Apotheker: Patient, Risiko, vorgeschlagene Alternative und Quelle. Die Apothekerin oder der Apotheker entscheidet. Der Agent ändert nichts in der Akte.
Das hat dieselbe Form wie das Lieferantenbeispiel: ein Dokument, mehrere Tabellen, eine Vorhersage, eine Suche, eine menschliche Entscheidung.
Bereits genutzte Chat-Assistenten
Dies sind reale Produkte und Forschungssysteme. Wir führen sie auf, um die Muster zu zeigen, nicht um eines davon zu empfehlen.
- Ambiente klinische Dokumentation. Microsoft Dragon Copilot (hervorgegangen aus Nuance DAX) und Abridge hören bei einem Gespräch mit und entwerfen die Notiz, die die Ärztin oder der Arzt anschließend bearbeitet. NHS England hat 2025 Leitlinien zu Ambient-Voice-Technologie veröffentlicht, die klinische Sicherheit, Datenschutz und die Pflicht abdecken, dass Kliniker jede Notiz prüfen. Das ist die Dokumentenspur in umgekehrter Richtung: Die KI schreibt das Dokument.
- Patientenseitige Triage und Selbstüberweisung. Limbic Access wird von NHS-Talking-Therapies-Diensten für die Selbstüberweisung genutzt und ist im Vereinigten Königreich als Medizinprodukt der Klasse IIa zertifiziert. Es ist ein gutes Beispiel für einen Chatbot, dessen Einsatzbereich bewusst eng und reguliert ist.
- Nicht-diagnostische Pflegeagenten. Hippocratic AI baut Sprachagenten für Aufgaben wie präoperative Erinnerungen und Nachkontrollen nach der Entlassung und hat 2024 eine Partnerschaft mit NVIDIA angekündigt. Die entscheidende Designentscheidung ist „nicht-diagnostisch“: Der Agent fasst nach und eskaliert, er stellt keine Diagnosen.
- Evidenzsuche für Kliniker. OpenEvidence beantwortet klinische Fragen aus der veröffentlichten Literatur mit Quellenangaben. Das ist die Dokumentenspur, angewandt auf Fachzeitschriften statt auf die eigenen Dateien eines Krankenhauses.
- Medizinische Modelle. MedGemma von Google ist eine Open-Weight-Modellfamilie für medizinische Texte und Bilder, und das Forschungssystem AMIE untersucht diagnostische Dialoge. Offene Gewichte bedeuten, dass ein Krankenhaus die Modelle auf eigener Hardware betreiben und mit eigenen Daten testen kann.
- Eine Warnung aus der Vergangenheit. Der Symptom-Checker von Babylon Health wurde breit beworben, und das Unternehmen brach 2023 zusammen. Ehrgeizige diagnostische Versprechen ohne entsprechende Evidenz sind der schnellste Weg, das Vertrauen von Klinikern zu verlieren.
Roboter im Krankenhaus
- Chirurgische Systeme wie da Vinci von Intuitive und Versius von CMR Surgical (gebaut in Cambridge) sind ferngesteuert: Die Chirurgin oder der Chirurg hat die Kontrolle. Die Forschung bewegt sich in Richtung Autonomie für Teile eines Eingriffs. 2025 berichtete ein Team der Johns Hopkins University von einem Roboter, der die Schritte einer Gallenblasenentfernung autonom an Ex-vivo-Gewebe durchführte, nicht an Patienten.
- Logistikroboter wie Moxi von Diligent Robotics holen und liefern Material und Proben, sodass Pflegekräfte weniger Zeit mit Laufwegen verbringen. Kommissionierroboter sind in NHS-Krankenhausapotheken bereits verbreitet.
- Der NVIDIA-Stack für diese Arbeit besteht aus Holoscan für die Echtzeitverarbeitung von Sensor- und Videodaten in Medizinprodukten, Isaac for Healthcare für die Simulation und das Training medizinischer Roboter sowie MONAI, dem Open-Source-Framework für medizinische Bildgebung, das NVIDIA zusammen mit dem King's College London ins Leben gerufen hat.
Bei Robotern trifft das Wissensfundament auf die physische Welt. Ein Lieferroboter braucht die Tabellenspur (welche Station, welches Bett, welche Probe ist dringend) weit mehr als einen Chatbot.
Die britischen Regeln, die das Design prägen
- Klinische Sicherheit: DCB0129 für den Hersteller und DCB0160 für die Organisation, die das System einsetzt, jeweils mit einem namentlich benannten Clinical Safety Officer und einem Gefährdungsprotokoll.
- Medizinprodukterecht: Software, die Diagnosen stellt oder Behandlungen empfiehlt, kann nach den Regeln der MHRA ein Medizinprodukt sein. Das AI Airlock der MHRA ist eine regulatorische Sandbox genau für solche Produkte. In der EU stuft der AI Act KI in Medizinprodukten als hochriskant ein.
- Datenschutz: Gesundheitsdaten sind nach der UK GDPR besondere Kategorien personenbezogener Daten. Rechnen Sie mit einer Datenschutz-Folgenabschätzung und halten Sie identifizierbare Daten aus Prompts, Protokollen und dem Modelltraining heraus, sofern keine Rechtsgrundlage besteht.
- Beschaffung: NHS-Organisationen bewerten Anbieter anhand der Digital Technology Assessment Criteria (DTAC) und des Data Security and Protection Toolkit (DSPT).
- Forschungszugang: Sichere Datenumgebungen des NHS und vertrauenswürdige Forschungsumgebungen wie OpenSAFELY bringen den Code zu den Daten statt umgekehrt. Ein Agent, der innerhalb dieser Grenze auf Hardware läuft, die die Organisation kontrolliert, passt weit besser zu diesem Modell als einer, der Akten an eine externe API sendet.
Wissenschaftliche Forschung: dieselben zwei Spuren
Labore haben dieselbe Aufteilung. Wissen steckt in Fachartikeln, Preprints, elektronischen Laborbüchern, Protokollen und Gerätehandbüchern. Messwerte liegen im Laborinformations- und Managementsystem (LIMS), in Plattenlesern, Sequenzierern und Simulationsausgaben, oft in Mengen, die nur GPUs komfortabel bewältigen.
Das Lieferantenbeispiel im Labor
- Ein Reagenzienlieferant ruft eine Charge zurück. Die Meldung wird geparst.
- Das LIMS zeigt jede Probe und jede Platte, für die diese Charge verwendet wurde.
- Eine analytische Abfrage (cuDF oder SQL) prüft, ob die Ergebnisse dieser Charge gegenüber den Kontrollen abgedriftet sind. Ein Vorhersagemodell markiert, welche nachgelagerten Experimente am wahrscheinlichsten betroffen sind.
- Die Vektorsuche über die SOPs und Laborbücher des Labors findet das validierte Alternativreagenz und eine etwaige frühere Bridging-Studie.
- Der Agent entwirft einen Plan für die Wiederholung. Eine Wissenschaftlerin oder ein Wissenschaftler genehmigt ihn, und ein Liquid-Handling-Roboter führt das Protokoll aus.
Frameworks und Modelle, die Forschende bereits nutzen
- Modelle für Biologie und Chemie. NVIDIA BioNeMo bündelt Modelle und Trainingsrezepte für Proteine, DNA und kleine Moleküle, darunter Evo 2, entwickelt mit dem Arc Institute. AlphaFold 3 von Google DeepMind und Isomorphic Labs sagt Strukturen und Wechselwirkungen vorher, und seine Entwickler erhielten 2024 einen Anteil am Nobelpreis für Chemie. Offene Alternativen sind OpenFold und Boltz, und ESM3 von EvolutionaryScale generiert Proteine.
- Daten im großen Maßstab. RAPIDS und cuDF beschleunigen tabellarische Arbeit. rapids-singlecell aus dem scverse-Projekt führt Einzelzellanalysen auf GPUs aus. NVIDIA Parabricks beschleunigt Pipelines zur Genomsequenzierung. Earth-2 und PhysicsNeMo decken Klima- und Physiksimulation ab.
- Forschungsagenten. Coscientist (Carnegie Mellon, 2023) und ChemCrow haben gezeigt, wie Sprachmodell-Agenten mit Tools Chemie planen und durchführen. PaperQA2 von FutureHouse beantwortet Fragen aus der Literatur mit Quellenangaben. Googles AI co-scientist (2025) generiert Hypothesen und bewertet sie. Der AI-Q Blueprint von NVIDIA ist ein Referenzdesign für Forschungsassistenten, das auf den Bausteinen der Folie aufbaut.
Laborroboter und selbstfahrende Labore
- Liquid Handler. Opentrons-Roboter werden über eine offene Python-Protokoll-API programmiert, was sie zu einem naheliegenden Werkzeug für einen Agenten macht: Der Agent schreibt oder wählt ein Protokoll, eine Wissenschaftlerin oder ein Wissenschaftler prüft es, der Roboter führt es aus.
- Mobile Roboterchemiker. Der mobile Roboterchemiker der University of Liverpool, 2020 in Nature beschrieben, führte über Tage hinweg Hunderte von Experimenten durch und wählte selbst aus, was als Nächstes zu versuchen war. Das A-Lab des Berkeley Lab automatisierte die Materialsynthese. Einige seiner Entdeckungsbehauptungen wurden angezweifelt, was eine nützliche Erinnerung daran ist, dass autonome Labore unabhängige Überprüfung brauchen.
- Cloud-Labore wie Emerald Cloud Lab ermöglichen es Forschenden, Experimente per Code aus der Ferne durchzuführen.
- Roboterlernen. Isaac Sim und Isaac Lab simulieren Roboter, bevor sie einen echten Labortisch berühren. Cosmos erzeugt synthetische Trainingsvideos. GR00T ist das Foundation Model von NVIDIA für humanoide Roboter. Im Open-Source-Bereich bleiben ROS 2 und MoveIt die Standardinfrastruktur, und LeRobot von Hugging Face sowie openpi von Physical Intelligence veröffentlichen Roboter-Policies, die jeder feinabstimmen kann.
Fünf Designregeln, die in beiden Bereichen gelten
- Nach Datenform routen. Dokumente gehen ins Retrieval. Tabellen gehen in SQL, Analyse oder Vorhersage. Lassen Sie den Agenten angeben, welche Spur er genutzt hat.
- Belegen oder schweigen. Jede Antwort zu einem Patienten oder einem Experiment sollte auf die zugrunde liegende Passage oder Abfrage verweisen. Findet das Retrieval nichts, lautet die richtige Antwort „Ich konnte das nicht finden“.
- Standardmäßig nur lesend. Der Agent schlägt vor. Eine Ärztin, ein Apotheker oder eine Wissenschaftlerin genehmigt. Schreibzugriffe auf die Akte, Bestellungen und Roboterläufe laufen über einen separaten, protokollierten Schritt.
- Mit eigenen Daten evaluieren. Erstellen Sie ein Testset aus echten Fragen mit bekannten Antworten aus Ihren eigenen Dokumenten und Tabellen und führen Sie es jedes Mal aus, wenn sich ein Modell, ein Parser oder ein Prompt ändert. Öffentliche Ranglisten kennen weder Ihre Arzneimittelliste noch Ihren Assay.
- Sensible Daten dort lassen, wo sie sind. Open-Weight-Modelle wie Nemotron, Llama, Qwen und MedGemma können auf Hardware innerhalb des Krankenhauses oder des Labors laufen. Das verkürzt Gespräche über Datenschutz, Audit und Forschungs-Governance erheblich.
Wie ein sinnvolles erstes Projekt aussieht
Wählen Sie eine Frage, die Menschen bereits von Hand beantworten, die sowohl ein Dokument als auch eine Tabelle erfordert und bei der eine falsche Antwort von einem Menschen abgefangen wird, bevor sie Folgen hat. Engpass-Arbeitslisten, vom Kliniker geprüfte Entwürfe von Entlassberichten, Literatursichtung für eine Forschungsgruppe oder Folgenberichte zu Reagenzienrückrufen sind gute Kandidaten. Betreiben Sie das Projekt auf einer einzelnen GPU-Workstation in Ihrem Netzwerk, messen Sie einen Monat lang die Genauigkeit anhand Ihres Testsets, und sprechen Sie erst dann über Skalierung.
Wenn Sie Hilfe bei der Dimensionierung dieser Maschine wünschen oder die offenen Modelle auf eigener Hardware betreiben möchten, sprechen Sie mit uns. Unser Leitfaden zu privaten KI-Workstations zeigt die Dimensionierungsmethode für einen anderen regulierten Berufsstand.
Produkt- und Forschungsnamen werden als Beispiele realer Systeme genannt und sind Marken ihrer jeweiligen Inhaber. Nichts hiervon ist eine klinische, regulatorische oder rechtliche Beratung. Prüfen Sie Ihre eigenen Pflichten zu klinischer Sicherheit, Medizinprodukten und Datenschutz, bevor Sie KI bei Patienten oder mit Patientendaten einsetzen.