KI-Rechenzentrumsdienste: Wie Workstation plant, aufbaut und übergibt
Standort, Strom, Kühlung, Netzwerk-Fabric, GPUs, Speicher und Software, vom Pilot-Rack bis zur Halle, mit einem 72-stündigen Burn-in, bevor Sie den Betrieb übernehmen.
 Balinder Walia17. November 20266 min read
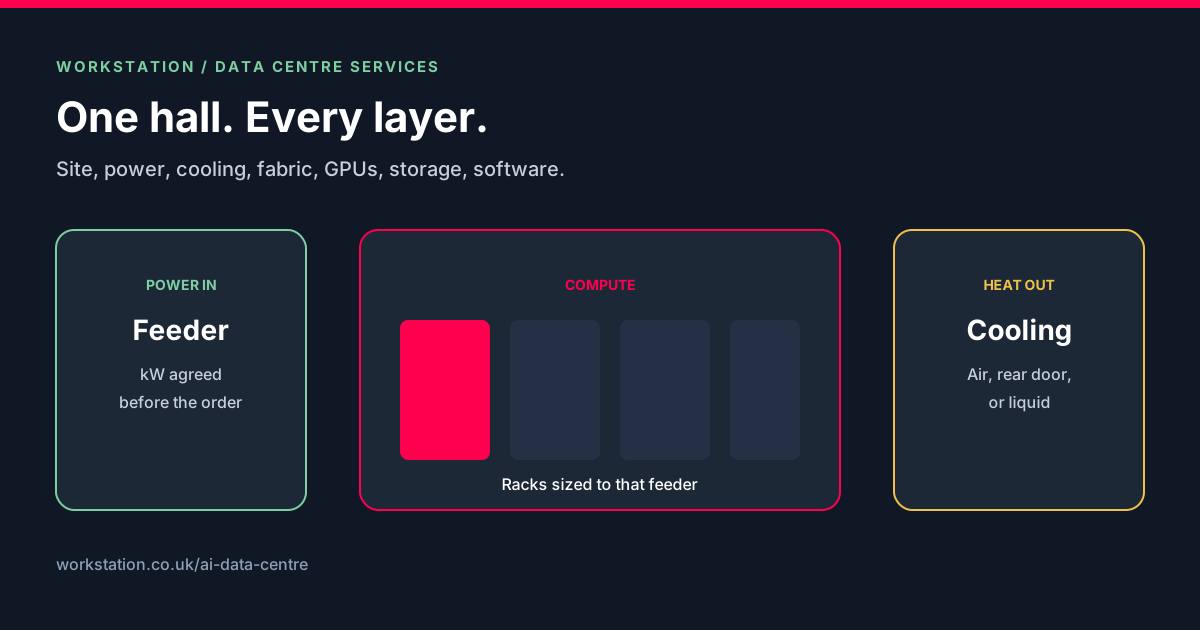
Ein KI-Rechenzentrum ist kein Serverraum mit schnelleren Karten darin. Strom, Wärme und Netzwerk müssen für die GPUs ausgelegt sein, sonst stehen die GPUs still. Workstation übernimmt diesen gesamten Weg: den Standort, die Kilowatt, die Kühlung, die Fabric, die Maschinen, die Software und eine Übergabe, mit der Sie den Betrieb führen können.
Der Begleitbeitrag Energie zuerst behandelt das Strombudget. Dieser hier behandelt den Service drumherum.
Für die GPU entworfen, nicht nachträglich um sie herum angepasst
Eine klassische Unternehmens-Rackreihe wurde für Server gebaut, die ein oder zwei Kilowatt aufnehmen. Ein luftgekühltes System mit acht GPUs wie NVIDIAs DGX B300 ist mit etwa 14 kW spezifiziert. Vier davon in einem Rack ergeben in NVIDIAs B300-Referenz etwa 56 kW. Rack-Scale-Systeme vom Typ NVL72 sind konstruktionsbedingt flüssigkeitsgekühlt. Wenn der Raum diese Wärme nicht abführen oder die Zuleitung sie nicht liefern kann, ist die Spezifikation im Angebot Fiktion.
Deshalb beginnt die Planung beim Workload und beim Gebäude zugleich.
- Kühlung, die zur Plattform passt. Luft, wenn der Raum es verträgt. Ein Rücktür-Wärmetauscher, wenn die Reihe dicht bestückt ist, die Maschinen aber noch luftgekühlt sind. Direkte Flüssigkeitskühlung mit Wasserkreislauf und Leckerkennung, wenn die Plattform Kühlplatten erfordert.
- Eine Fabric, die die GPUs nicht aushungert. ConnectX-7- und ConnectX-8-Adapter mit bis zu 800 Gb/s, BlueField-3 für Speicher und Management, Spectrum Ethernet oder Quantum InfiniBand zwischen den Knoten. Das Netzwerk ist Teil der Maschine, kein späteres Upgrade.
- Strom, den Sie beziffern können. Kilowatt pro Rack, USV- und Generatorabdeckung und verbleibende Reserve auf der Zuleitung. Wir verkaufen kein Erzeugungsprojekt. Wir planen die Last, die der Standort bereits hat, oder die Colocation-Fläche bzw. das erschlossene Grundstück, das Sie noch sichern müssen.
Was wir tatsächlich tun
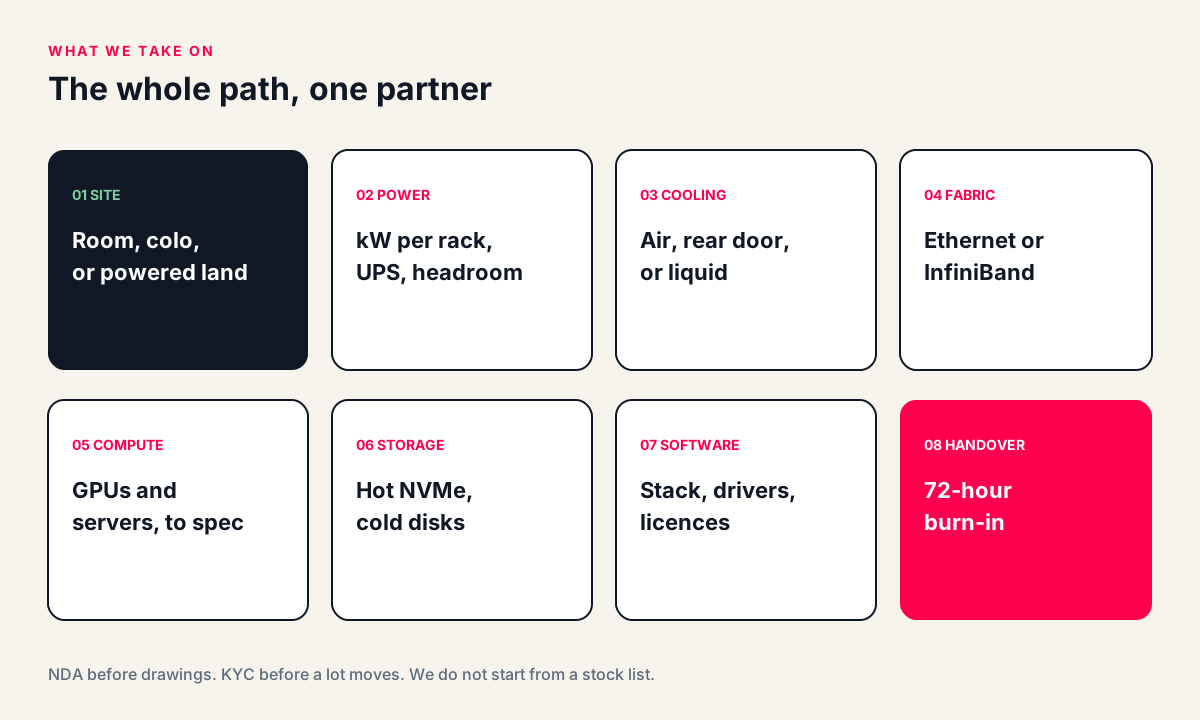
Standort
Ein Cluster kann an drei Orten stehen. In einem Raum, den Sie bereits haben, wenn Stromversorgung und Bodenbelastbarkeit tatsächlich ausreichen. In einer Colocation-Halle, wenn das Gebäude die Einschränkung ist und die Daten trotzdem an einem bekannten Ort bleiben müssen. Auf einem erschlossenen Grundstück oder mit einem verfügbaren Megawatt, wenn Sie der Betreiber sind und die Halle noch nicht existiert. Wir helfen beim Erwerb dieser Kapazität. Wir sagen Ihnen auch, wenn der Raum, den Sie nutzen wollten, die Maschinen nicht aufnehmen kann.
Strom und Kapazität
Der KI-Rechenzentrumsplaner verwendet Richtwerte, damit ein Pilotprojekt nicht versehentlich zu einem Megawatt-Design wird: unter 1 kW auf dem Schreibtisch, 1,5 bis 3 kW für ein Team, 6 bis 20 kW für ein Rack, 40 bis 130 kW für einen Pod und 0,5 bis 5 MW für eine Fabrik. Das sind Planungsbereiche. Die Standortbegehung ersetzt sie durch die Werte Ihrer Zuleitung. Ein Rechenbeispiel steht im Leitfaden für KI-Rechenzentren: Ein DGX B300 mit seiner Nennleistung von 14 kW verbraucht bei voller Last 122.640 kWh pro Jahr, vor Berücksichtigung der Power Usage Effectiveness.
Kühlung
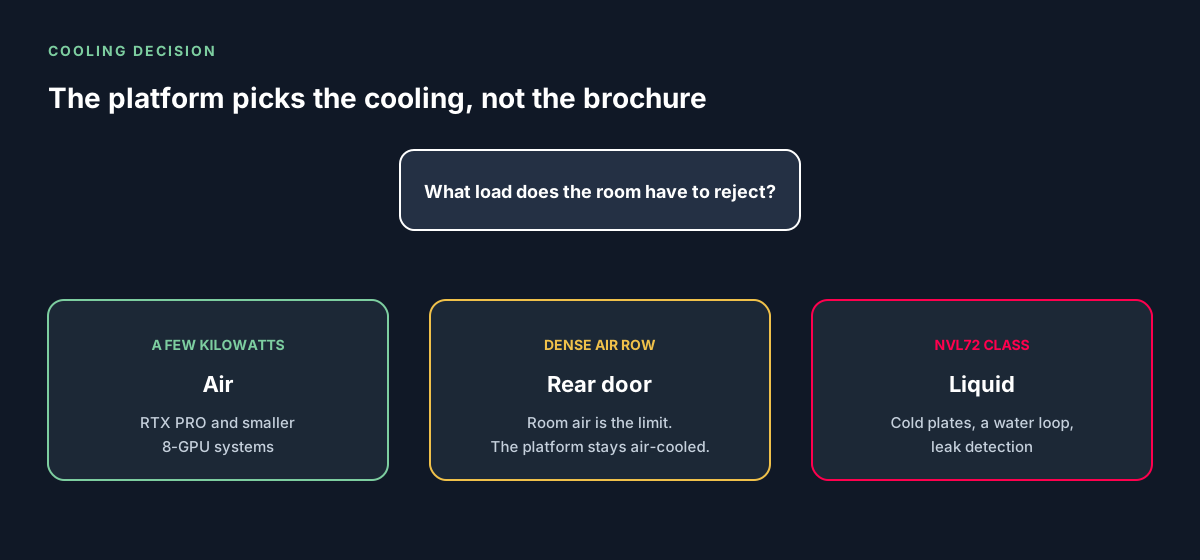
Flüssigkeitskühlung wird spezifiziert, wenn die Plattform sie erfordert oder wenn die Luft den Raum nicht verlassen kann. Sie wird nicht spezifiziert, damit ein Angebot moderner aussieht. Geschlossene Flüssigkeitskreisläufe, bei denen das Kühlmittel im Rack-Kreislauf bleibt und die Wärme an einem Kühler abgibt, sind eine Möglichkeit, die Dichte zu erhöhen, ohne die gesamte Halle umzubauen. Sie erfordern dennoch eine Planung, einen Leckageplan und einen Vermieter, der zustimmt.
Rechenleistung
Beschafft nach Ihrer Spezifikation, neu oder geprüft aufbereitet. Passiv gekühlte Rechenzentrums-GPUs, darunter H100, L40S und RTX PRO Blackwell Server Edition. Komplette Systeme: 4U-Server mit acht GPUs, HGX B200 auf Anfrage, DGX Station und DGX Spark. Wenn Sie eine ältere Generation mit acht GPUs erneuern, vermitteln wir die ausscheidende Hardware und liefern die nächste. Herkunft, Zustand und Garantie werden geprüft, bevor eine Charge angeboten wird. Wenn wir eine verfügbare Charge teilen, vertreten wir unseren Kunden.
Speicher
Heiße Daten auf reinen NVMe-Knoten, darunter 2U-Server mit 24 Einschüben und PCIe-5.0-Laufwerke, und kältere Daten auf großen Enterprise-Festplatten. Trainingsdatensätze, Checkpoints und Retrieval-Korpora gehören nicht auf die Boot-Laufwerke des GPU-Servers.
Netzwerk
Die oben genannten Adapter, DPUs und Switches, dimensioniert nach der Anzahl der GPUs statt vom Büronetzwerk des Vorjahres abgeschrieben. Eine Fabric, die eine Generation hinter den GPUs zurückliegt, zeigt sich als untätige Beschleuniger, nicht als langsam blinkende Switch-LED.
Arbeitsspeicher, CPUs und der Rest des Systems
Registrierter DDR5-ECC-Arbeitsspeicher und die CPUs, die die Plattform erwartet, einschließlich Threadripper PRO und EPYC, wo dies der richtige Host ist. Upgrades für Maschinen, die Sie bereits besitzen, wenn Gehäuse und Strombudget es zulassen.
Software
Betriebssystem, Rechenzentrumstreiber, das Container-Toolkit und NVIDIA AI Enterprise, wo die Bereitstellung den unterstützten Stack benötigt. Zur Übergabe gehört eine Maschine, die Ihre Modelle ausführt, keine Palette mit Packliste.
Installation und Burn-in
Installation vor Ort, danach ein 72-stündiger Burn-in für jedes Rack, das wir installieren. Der Sinn des Burn-ins ist, dass ein Netzteil, ein DIMM oder eine GPU während unserer Zeit ausfällt, nicht während Ihrer.
Tempo, ohne so zu tun, als bewege sich das Stromnetz über Nacht
Ein Partner ist schneller als eine Kette aus Standortmakler, TGA-Berater, Wiederverkäufer und separatem Installateur, die nie die Zeichnungen der anderen gelesen haben. Anforderungen, eine gegenseitige NDA, Standard-KYC, dann Optionen, die zu Spezifikation, Budget und Termin passen. Das ist die Reihenfolge. Sie beseitigt Übergaben. Sie beseitigt kein Umspannwerk.
Die Lieferzeitangabe des Planers reicht von etwa einer Woche für ein Schreibtischsystem bis zu 16 bis 40 Wochen für ein Design im Fabrikmaßstab. Eine Standortbegehung kann diese Zahlen verschieben. Plattformen, die nur auf Anfrage erhältlich sind, darunter HGX B200 und NVL72, bleiben auf Anfrage, weil Zuteilung und Arbeiten vor Ort den Termin bestimmen. Systeme im AI Shop haben Live-Preise.
Modulares Wachstum ist die Art, wie die meisten unserer Kunden tatsächlich erweitern. Weisen Sie die Tauglichkeit für den Workload auf einem Server nach. Ergänzen Sie dieselbe Konfiguration, wenn die Zuleitung Reserven hat. Ein einheitlicher Aufbau lässt sich leichter kühlen, mit Ersatzteilen versorgen und betreiben als eine Reihe von Einzelstücken.
Wann Sie die Halle nicht bauen sollten
Wenn die Daten an einem bekannten Ort liegen können und das Gebäude die Einschränkung ist, ist eine private GPU-Cloud dieselbe Dimensionierungsaufgabe ohne Umspannwerk. Sie brauchen dennoch ein Konzept für Strom und Kühlung. Es gehört zu der Halle, die Sie mieten, und wir dimensionieren die GPUs weiterhin passend dazu.
Wenn Sie überschüssige GPU-Server haben, helfen wir, sie bei geprüften Käufern unterzubringen. Das ist ein separates Gespräch, unabhängig von einem Neubau, und es beginnt mit derselben NDA.
Was dieser Service nicht ist
- Kein Kraftwerk. Wir entwickeln keine Stromerzeugung und bieten weder Geothermie, Kernkraft noch ein Gaskraftwerk an, als wäre Workstation der Energieversorger. Ihr Energievertrag bleibt bei Ihrem Versorger. Wir sagen Ihnen, wie viele Kilowatt das Design benötigt.
- Keine Lagerliste. Die Maschinen richten sich nach der Standortbegehung. Wenn das einzige passende System kleiner ist als das im Briefing, ist genau das die Empfehlung.
- Kein fester Campus-Zeitplan. Monate sind realistisch für ein Rack in einem Raum, der es aufnehmen kann. Eine neue Halle richtet sich nach Strom, Genehmigungen und Kälteanlage.
- Keine Broschüre mit Spitzen-FLOPS. NVIDIAs Durchsatzangaben sind NVIDIAs Angaben. Wir dimensionieren nach Ihren Modellen, Ihren Nutzern und Ihrer Zuleitung.
Wie Sie beginnen
- Beantworten Sie die sieben Fragen im Planer. Sie erhalten ein Profil, eine Stufe und eine Einschätzung zu Budget, Strom und Zeit. Ohne Registrierung.
- Oder senden Sie uns Standort und Workload: eingehende Stromversorgung, die Modelle, die Anzahl der Nutzer und ob die Maschinen in einem von Ihnen benannten Raum bleiben müssen.
- Wir unterzeichnen eine NDA, bevor Zeichnungen oder eine Chargenliste ausgetauscht werden, dann folgen KYC und ein schriftlicher Satz von Optionen.
Quellen
- Workstation: KI-Rechenzentrumslösungen
- Workstation: Energie zuerst
- Workstation: Leitfaden für NVIDIA-KI-Rechenzentren
- NVIDIA: DGX B300
Marken. NVIDIA, DGX, NVL72, ConnectX, BlueField, Spectrum und Quantum sind Marken der NVIDIA Corporation. AMD, Threadripper und EPYC sind Marken von Advanced Micro Devices, Inc. Der Wert von 14 kW ist NVIDIAs Nennleistung für den DGX B300 und dient als Beispiel. Leistungsbereiche und Lieferzeiten sind Planungswerte von Workstation und werden vor einem Angebot durch eine Standortbegehung ersetzt.